Fundamentos do processo
Amostra, extração, biblioteca, adaptadores, índices e reads.
O Que Significa Sequenciar?
Quando dizemos que um DNA foi “sequenciado”, estamos dizendo que tentamos determinar a ordem dos nucleotídeos presentes naquela molécula. Em outras palavras, queremos descobrir a sequência de bases que compõem determinado fragmento.
Uma representação simplificada poderia ser:
ACGTTGCAATCGGATC
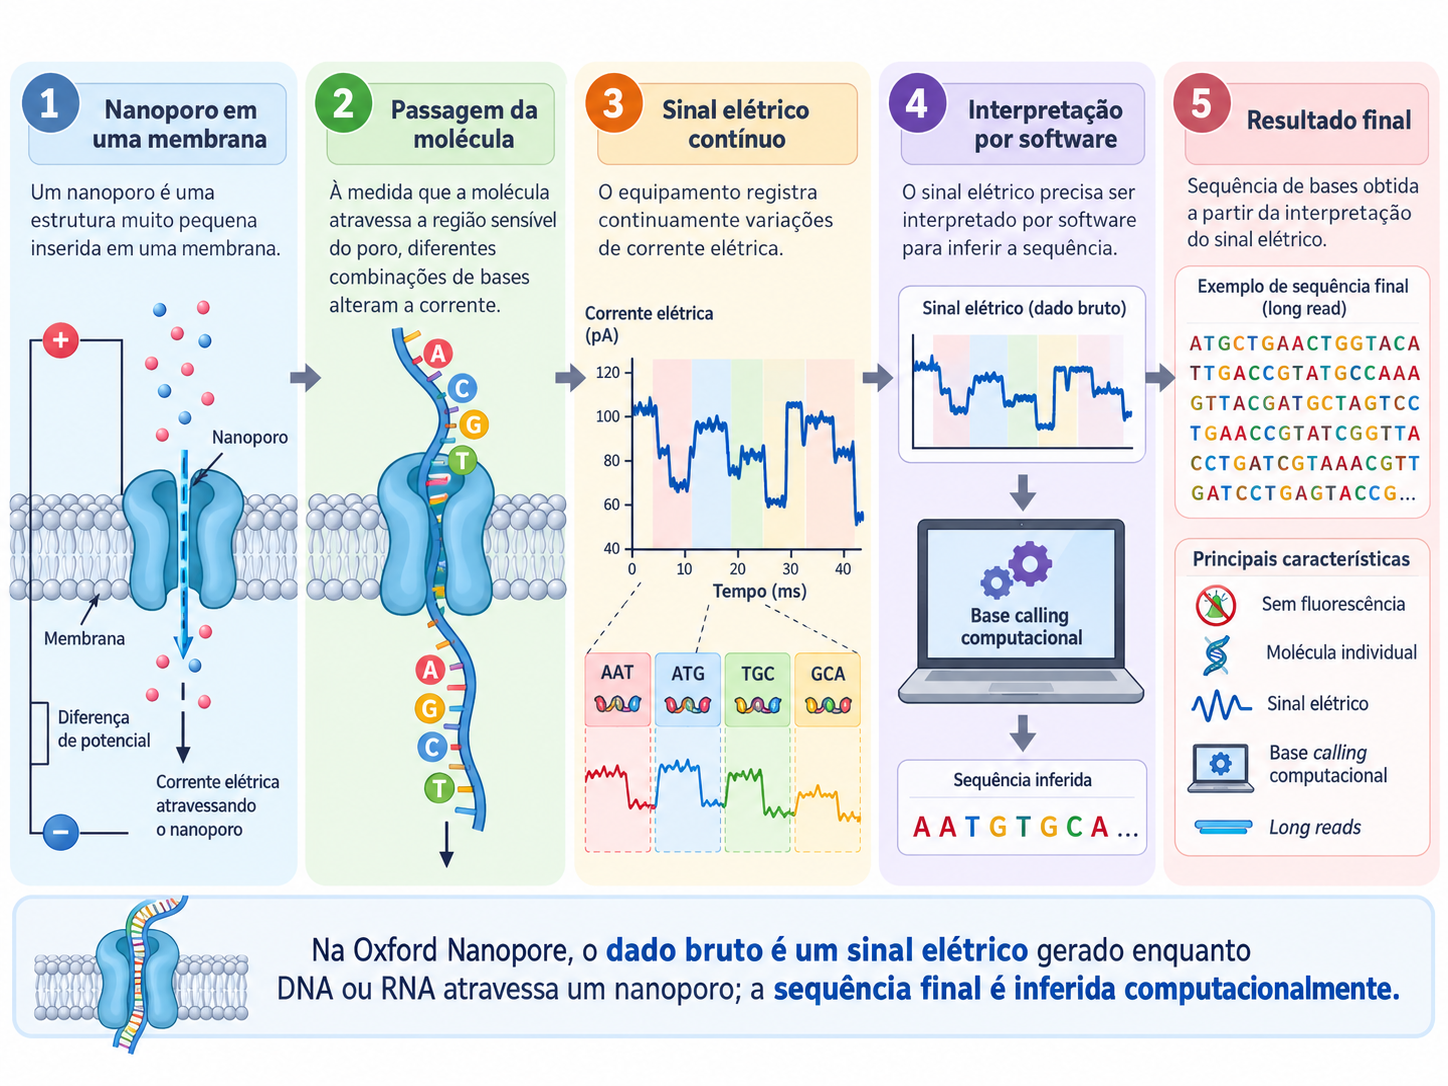
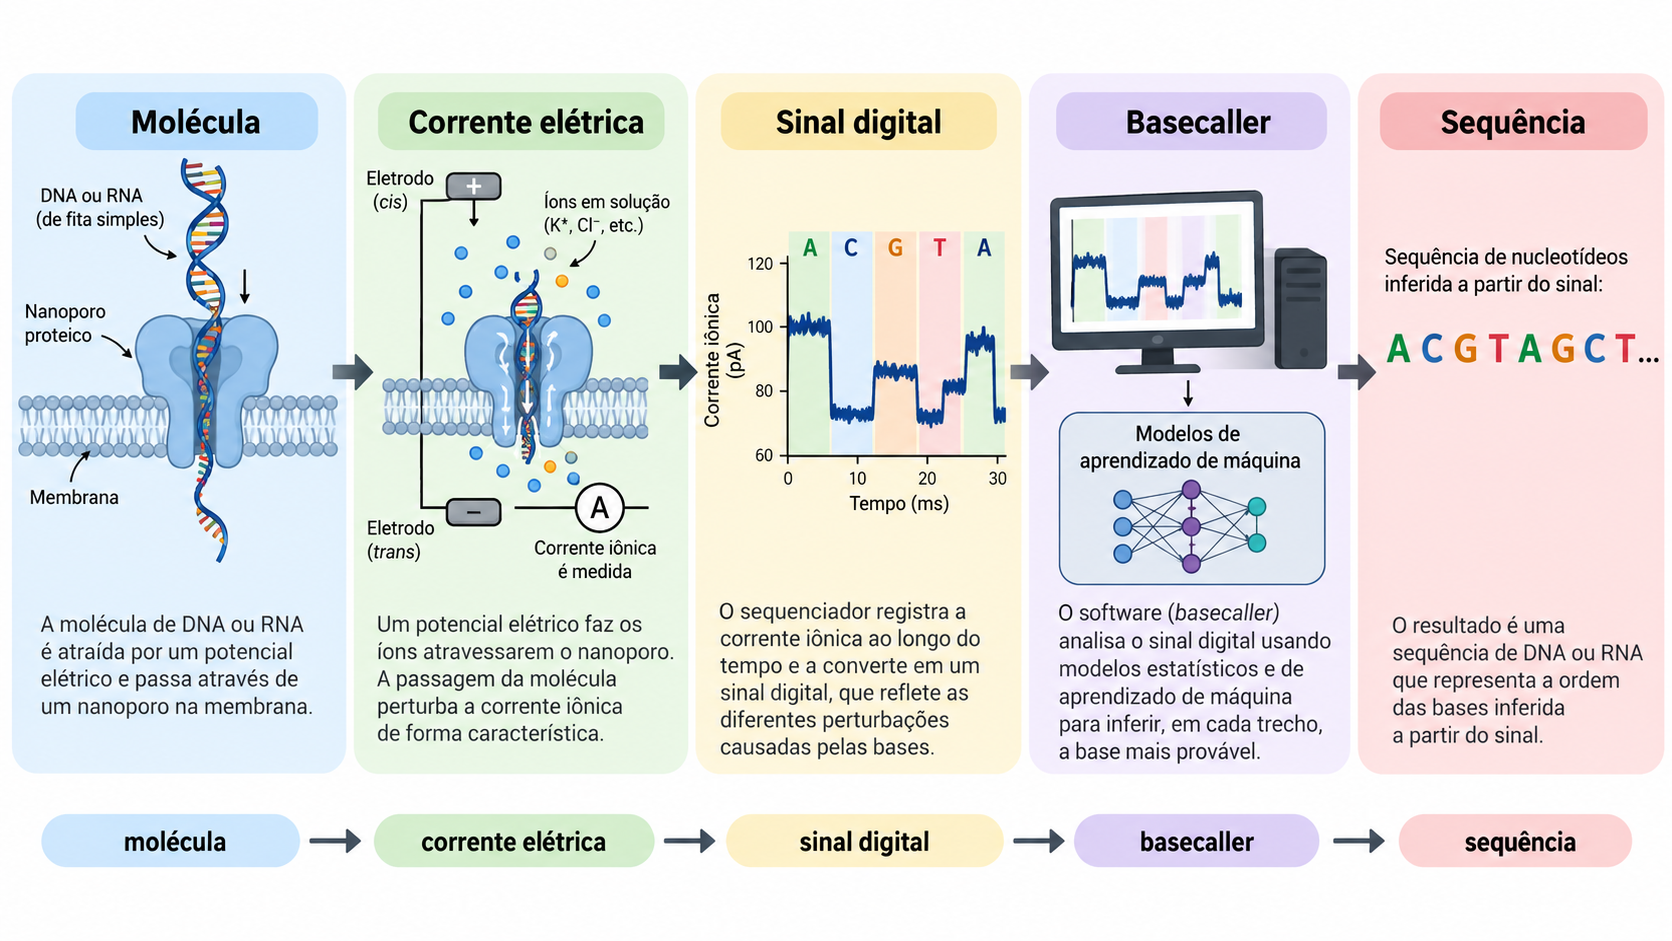
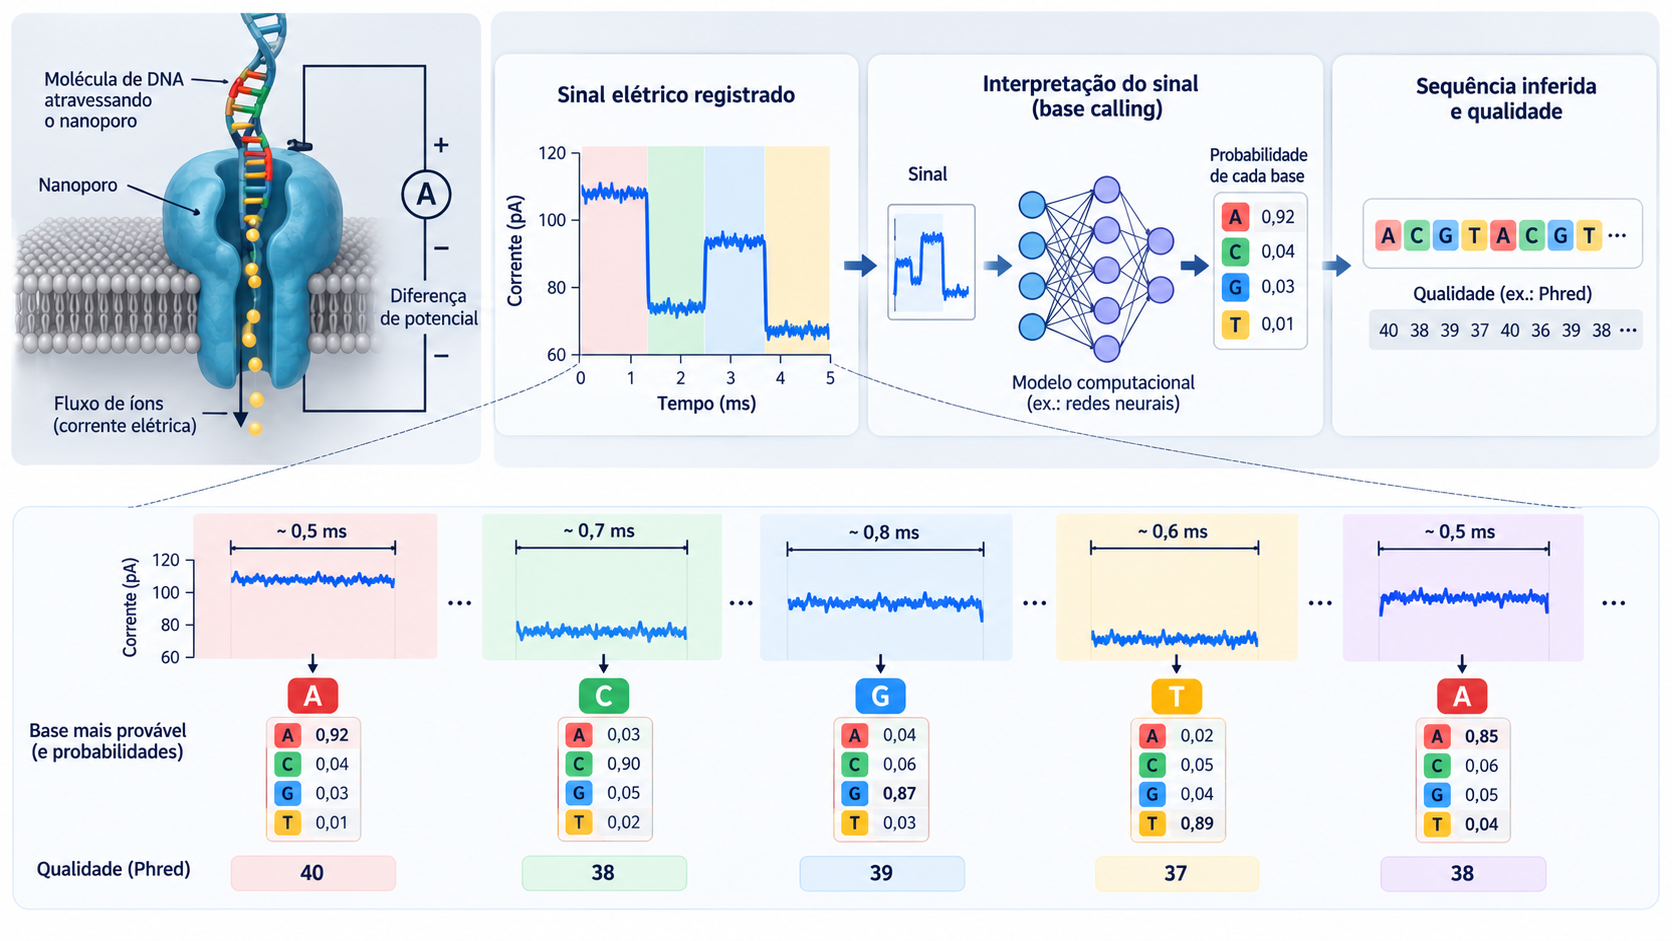
Entretanto, nenhum sequenciador observa diretamente essas letras. A molécula de DNA não possui um “A” escrito sobre uma adenina nem um “G” escrito sobre uma guanina. O equipamento precisa inferir a identidade das bases a partir de fenômenos físicos ou químicos que acontecem durante o processo de leitura.
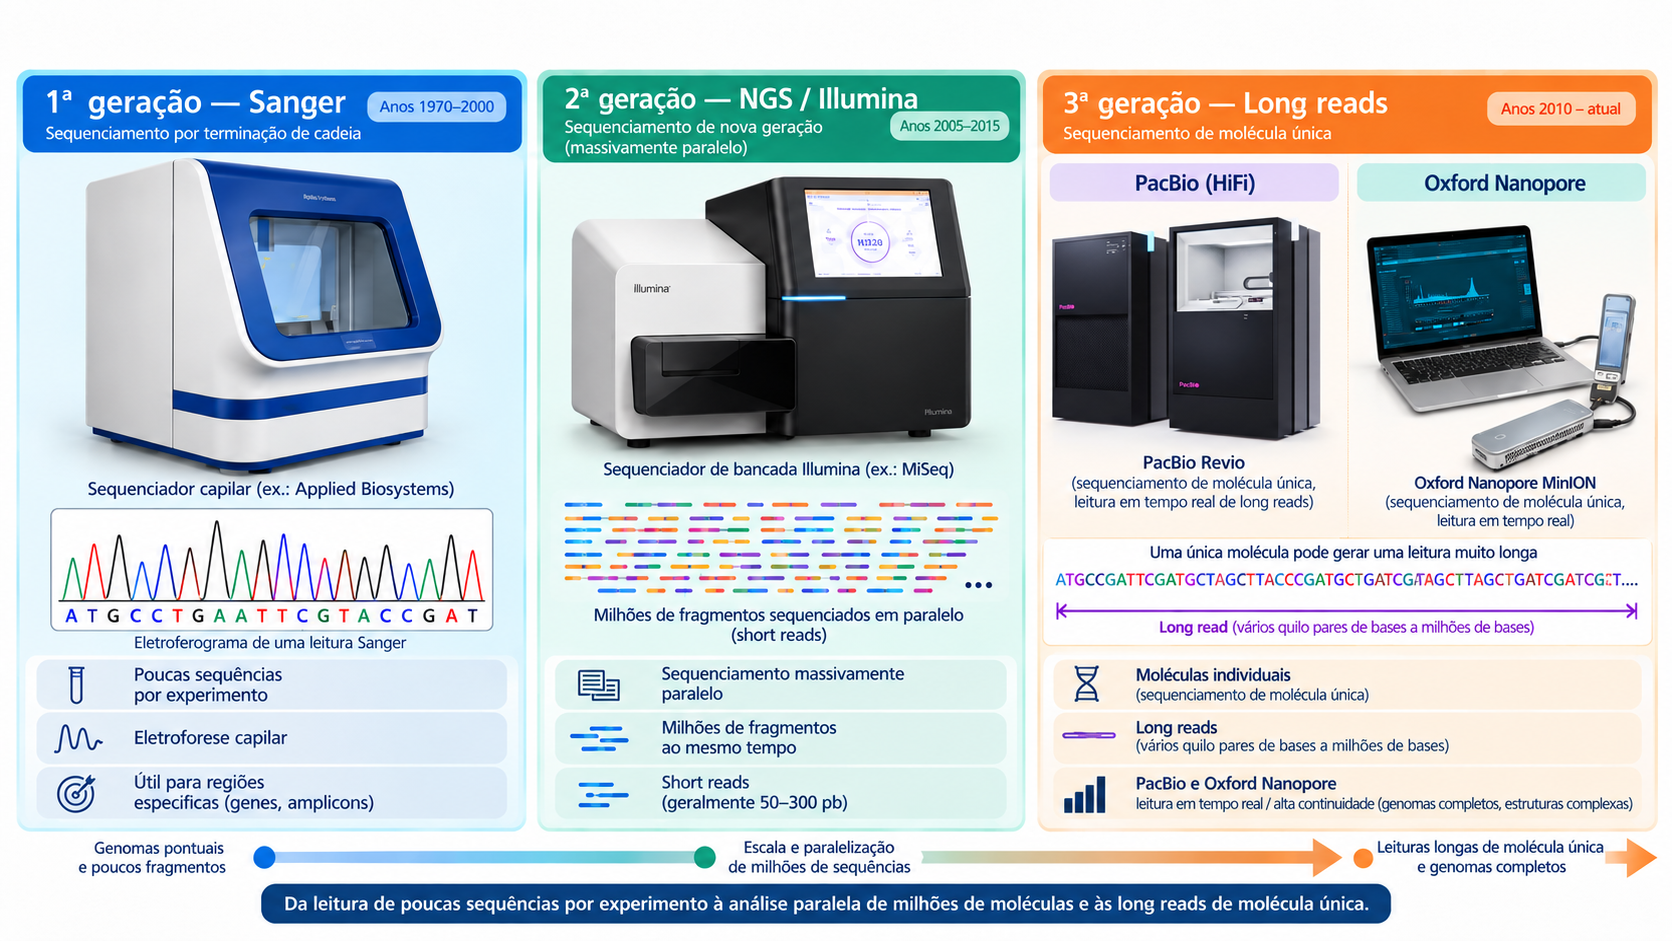
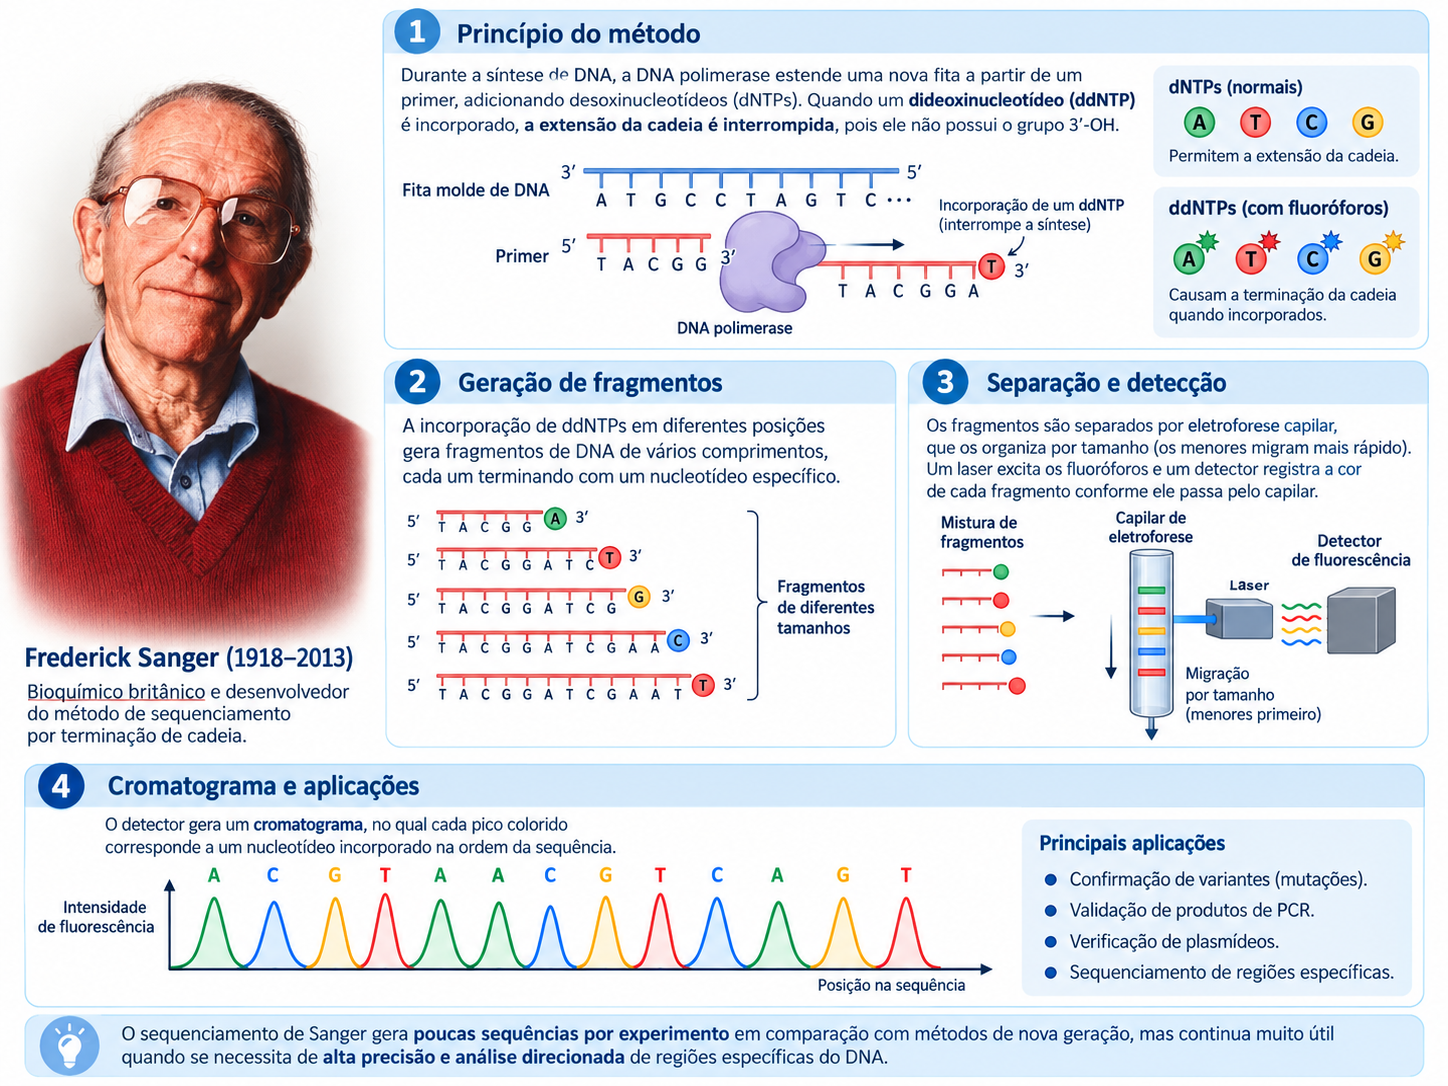
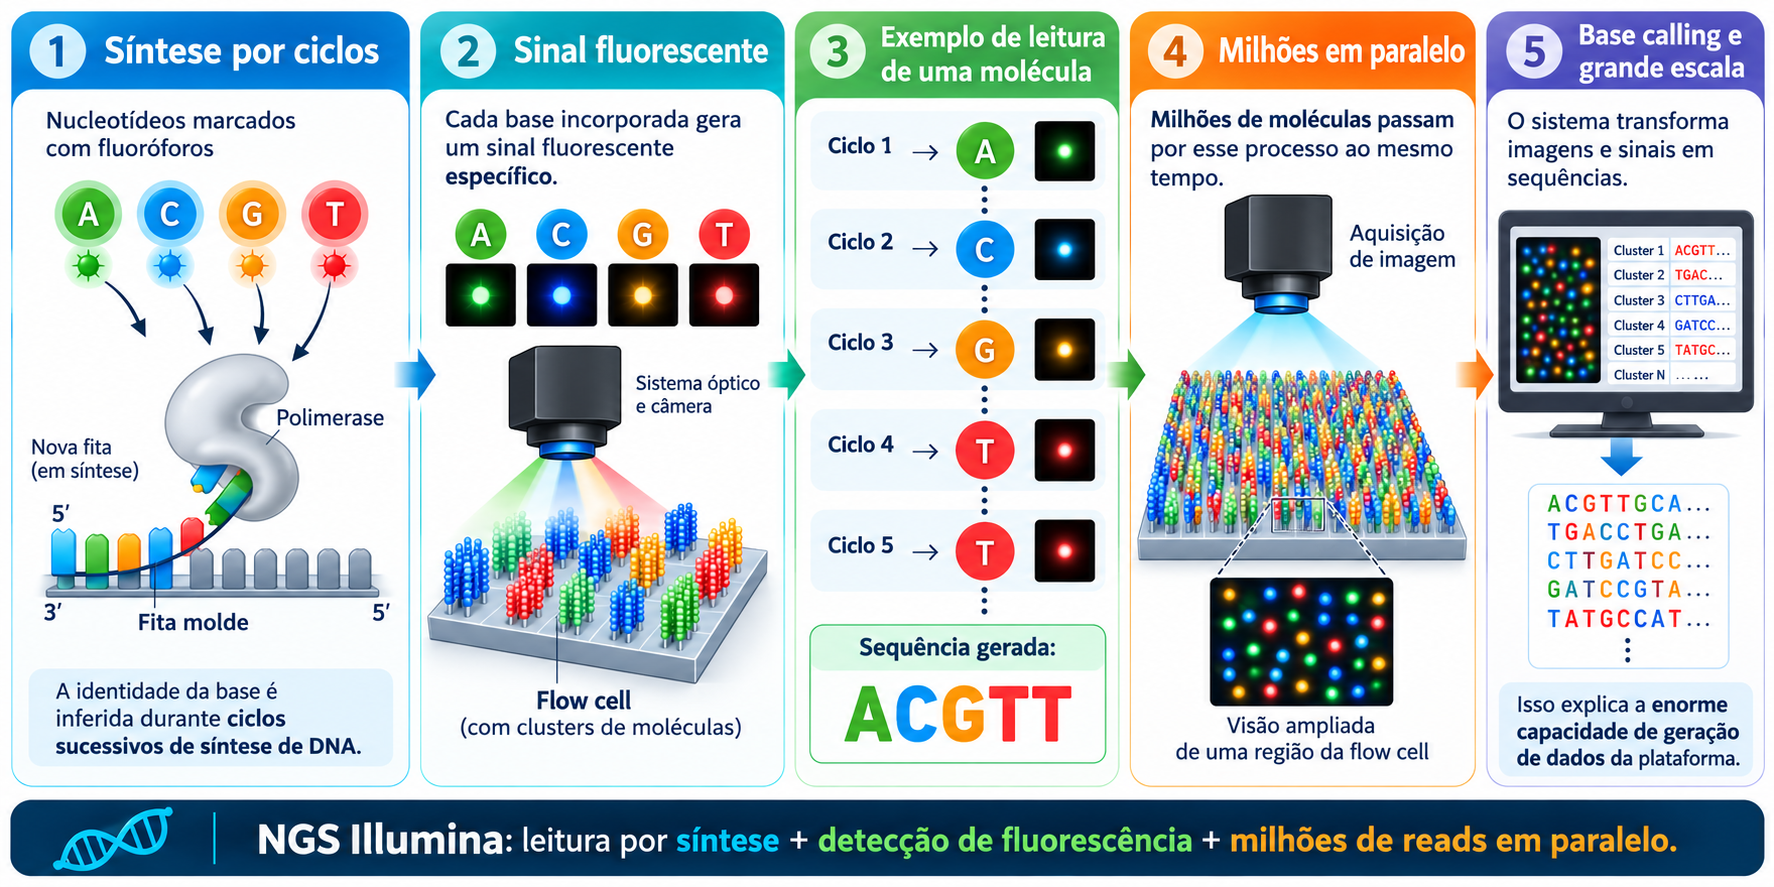
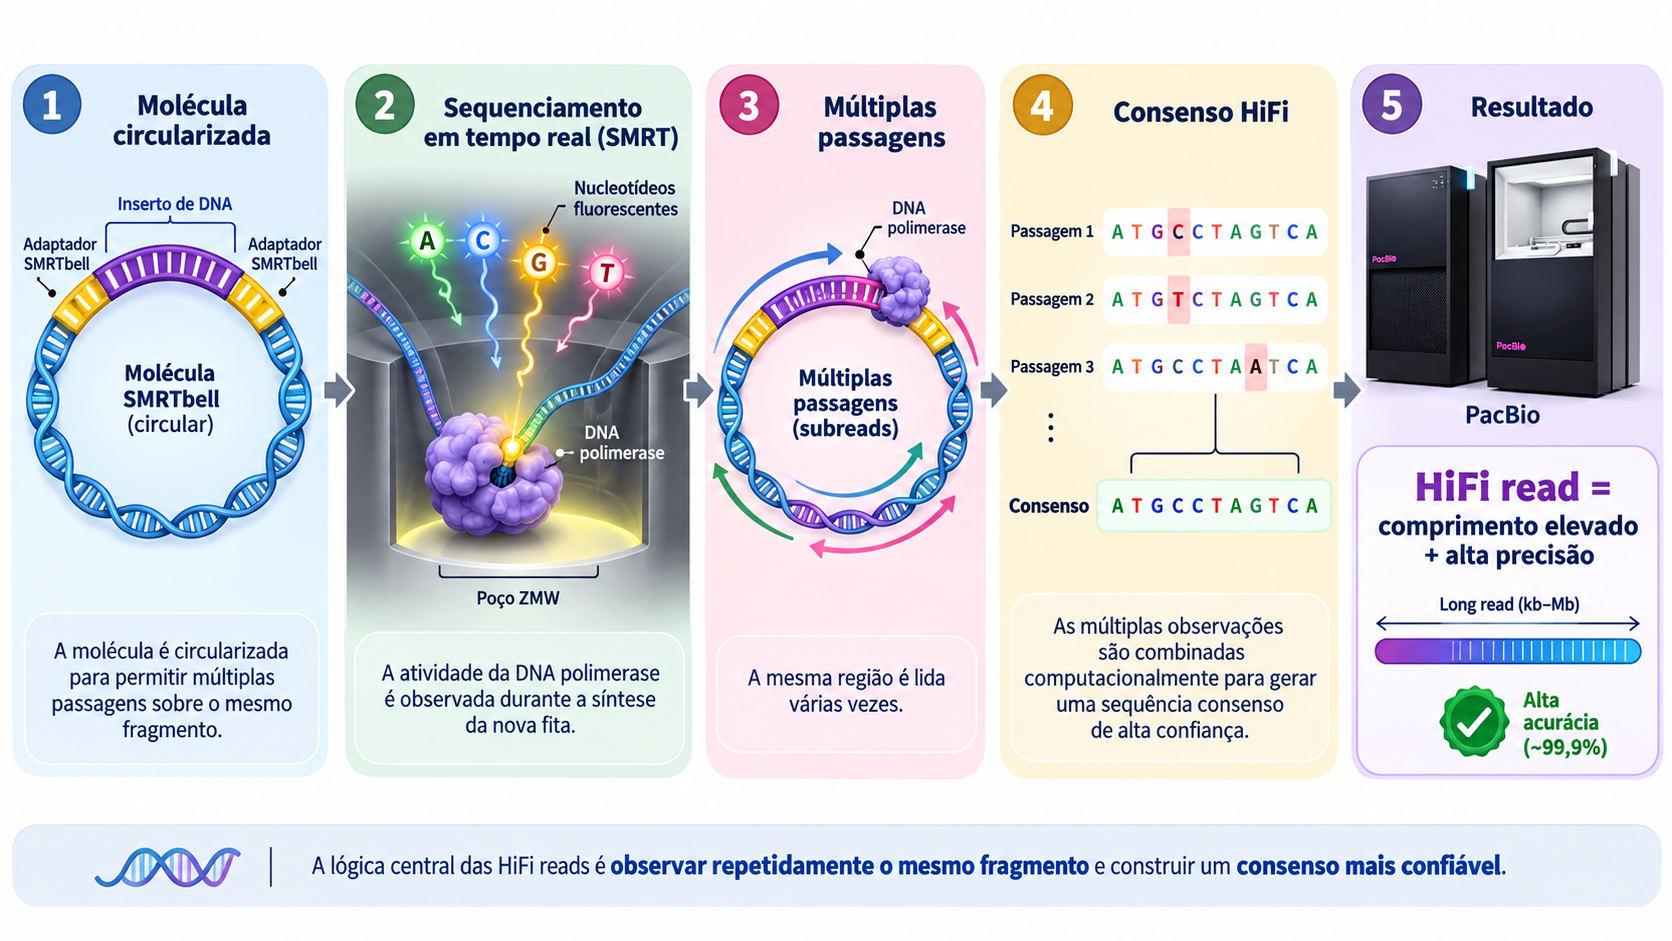
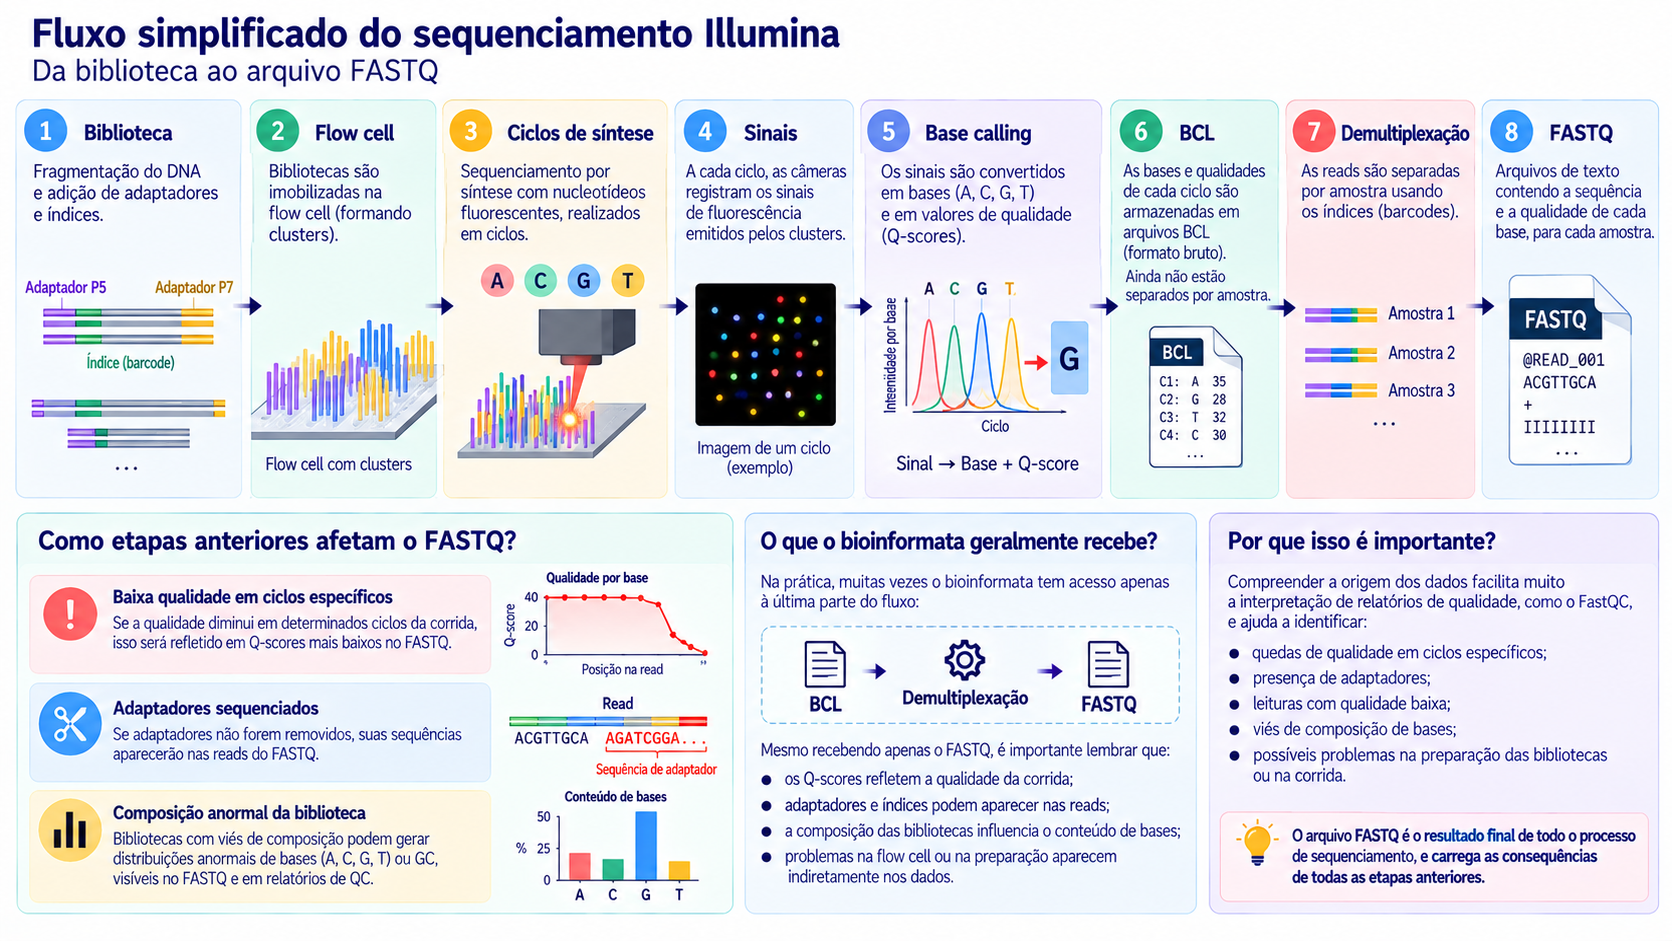
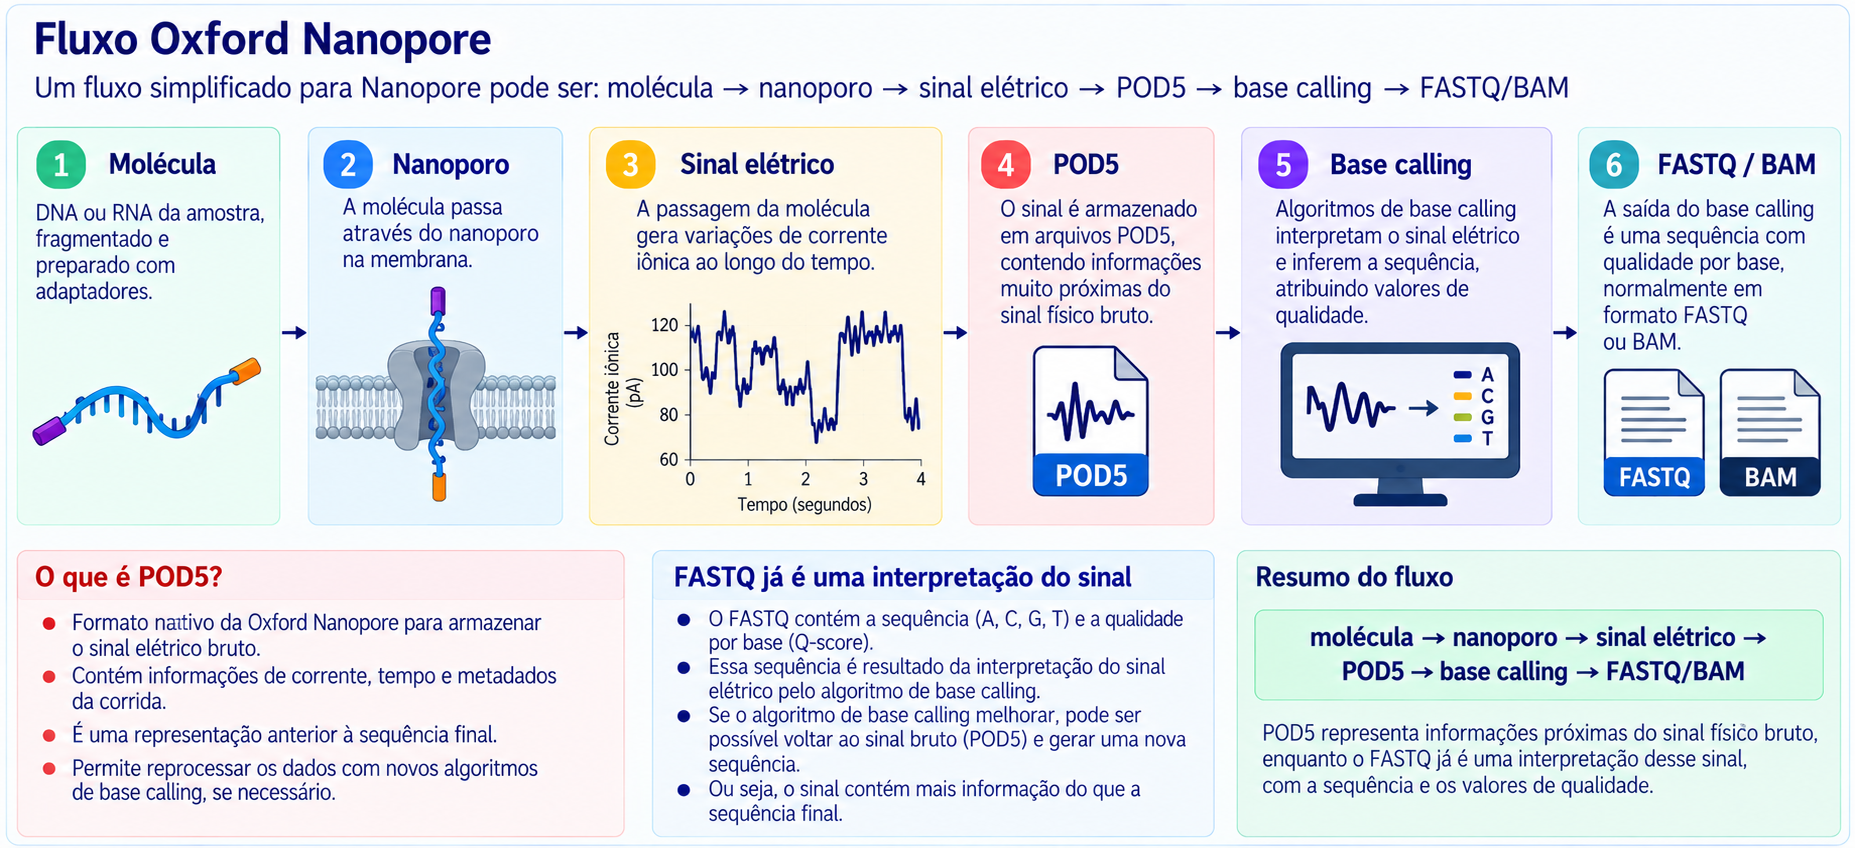
Dependendo da tecnologia, o sequenciador pode detectar fluorescência produzida durante a incorporação de nucleotídeos, alterações na corrente elétrica provocadas pela passagem de DNA por um nanoporo, diferenças no comprimento de fragmentos separados por eletroforese ou outros eventos moleculares.
Portanto, uma forma mais correta de compreender o sequenciamento é:
sequenciar é transformar propriedades moleculares em sinais mensuráveis e, posteriormente, transformar esses sinais em uma sequência de bases.
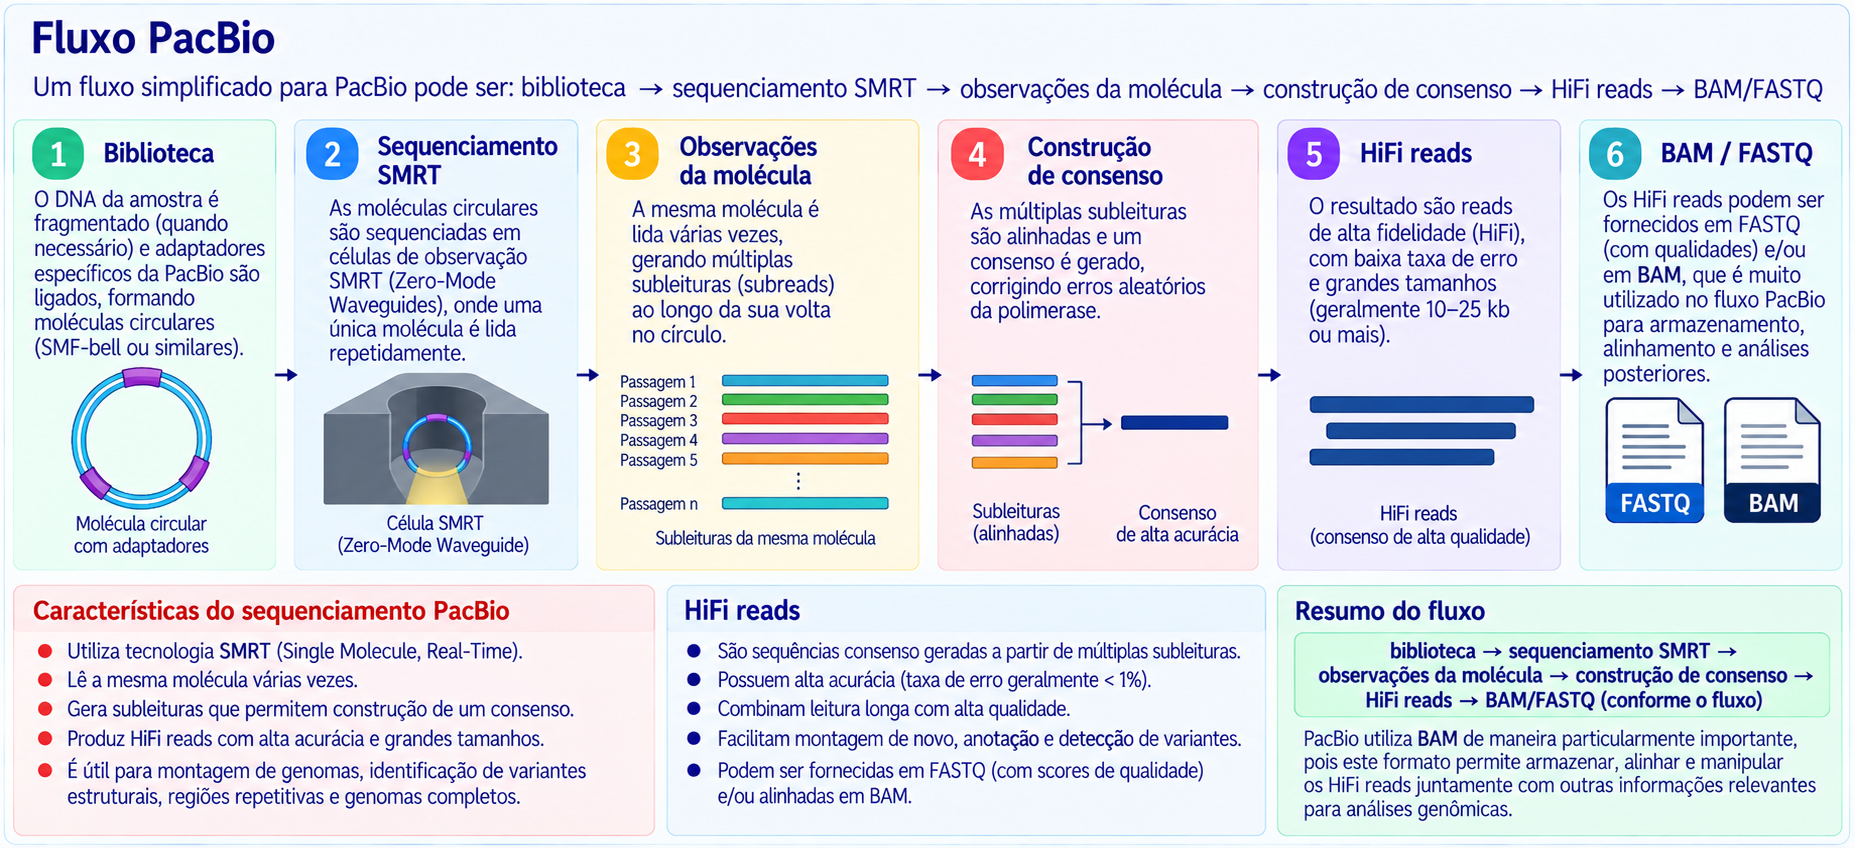
Existe, portanto, uma cadeia de conversões:
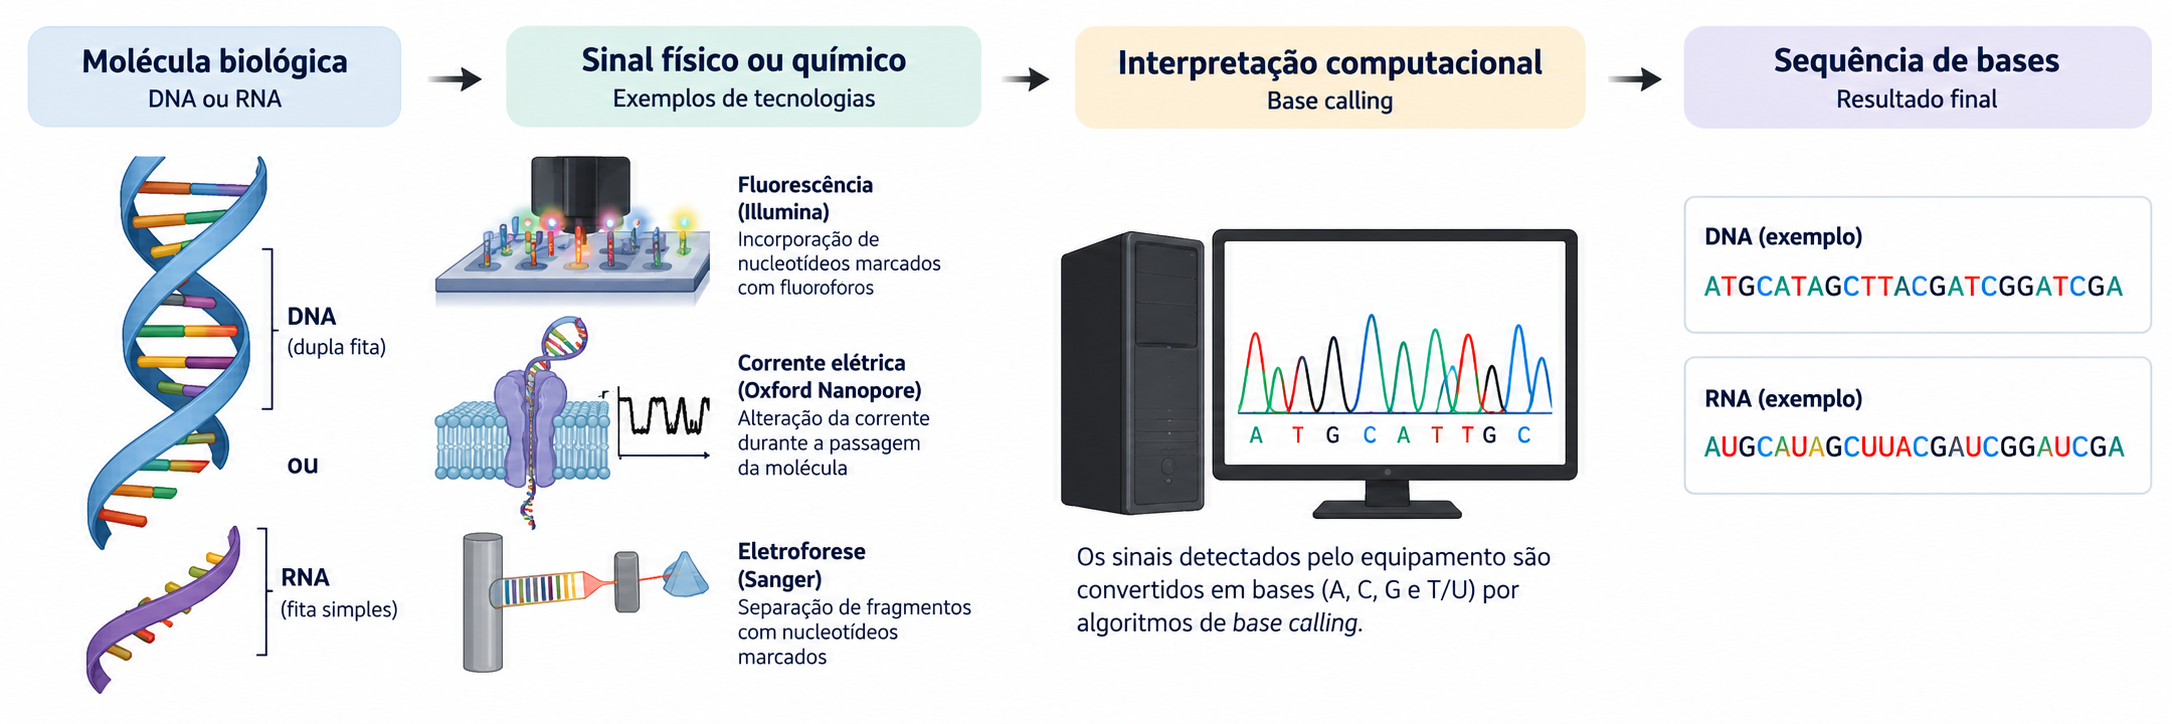
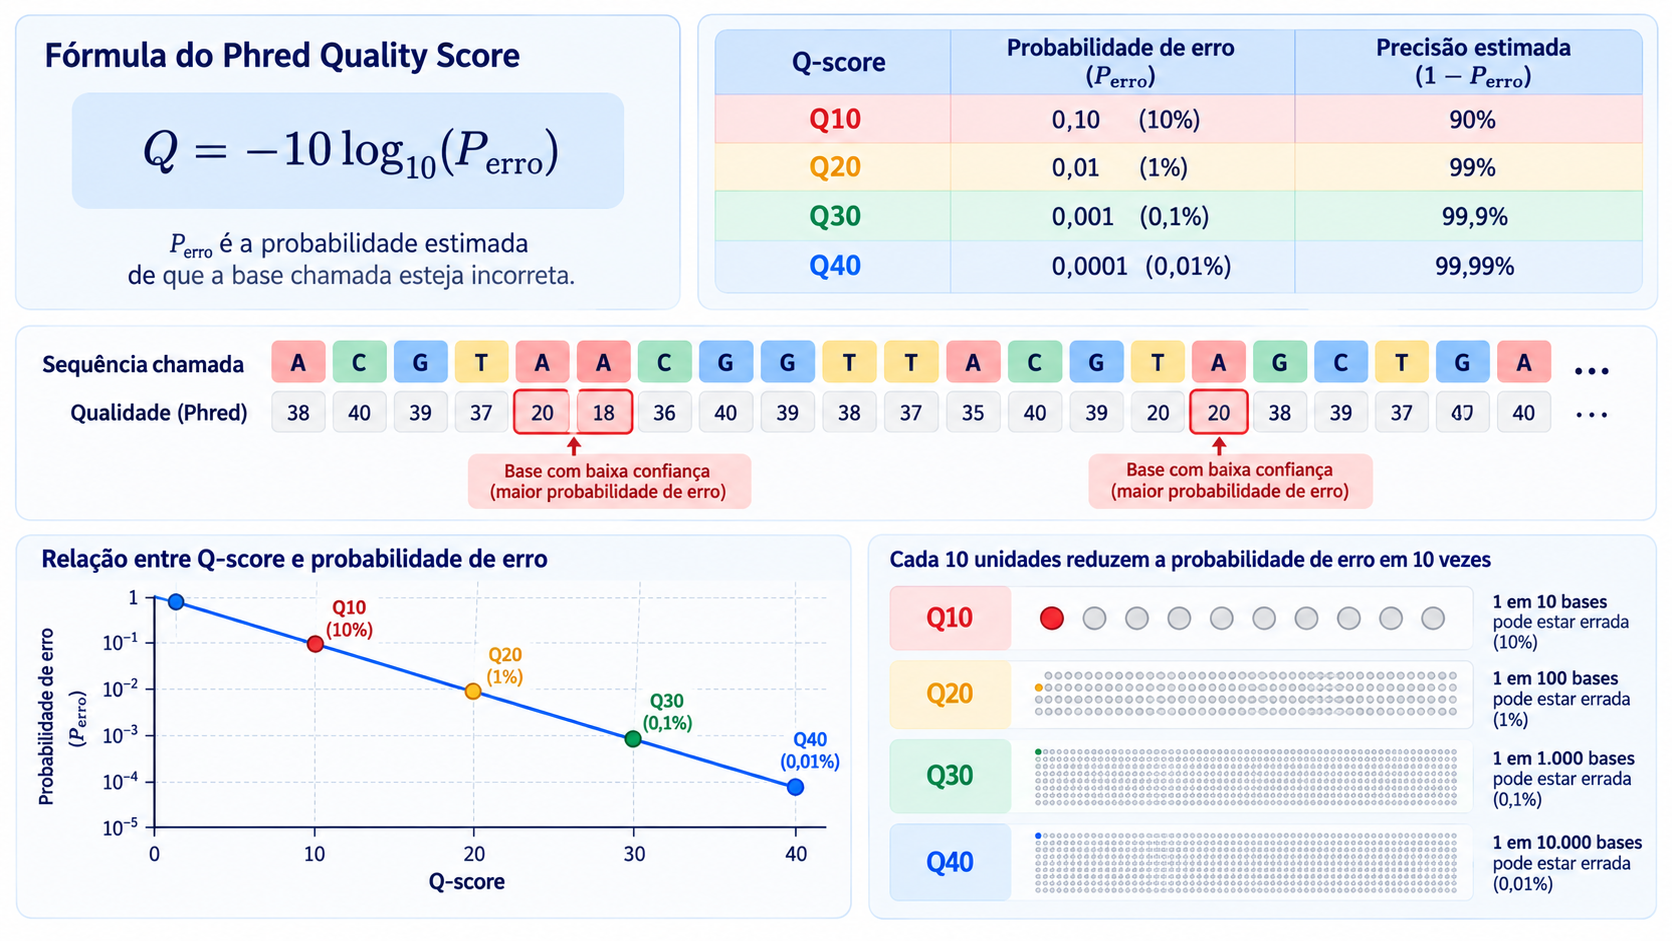
Essa interpretação computacional é extremamente importante. Em praticamente todas as tecnologias modernas, existe algum processo computacional entre o sinal detectado pelo equipamento e a sequência que será entregue ao pesquisador.
Do Organismo Ao Dado Digital
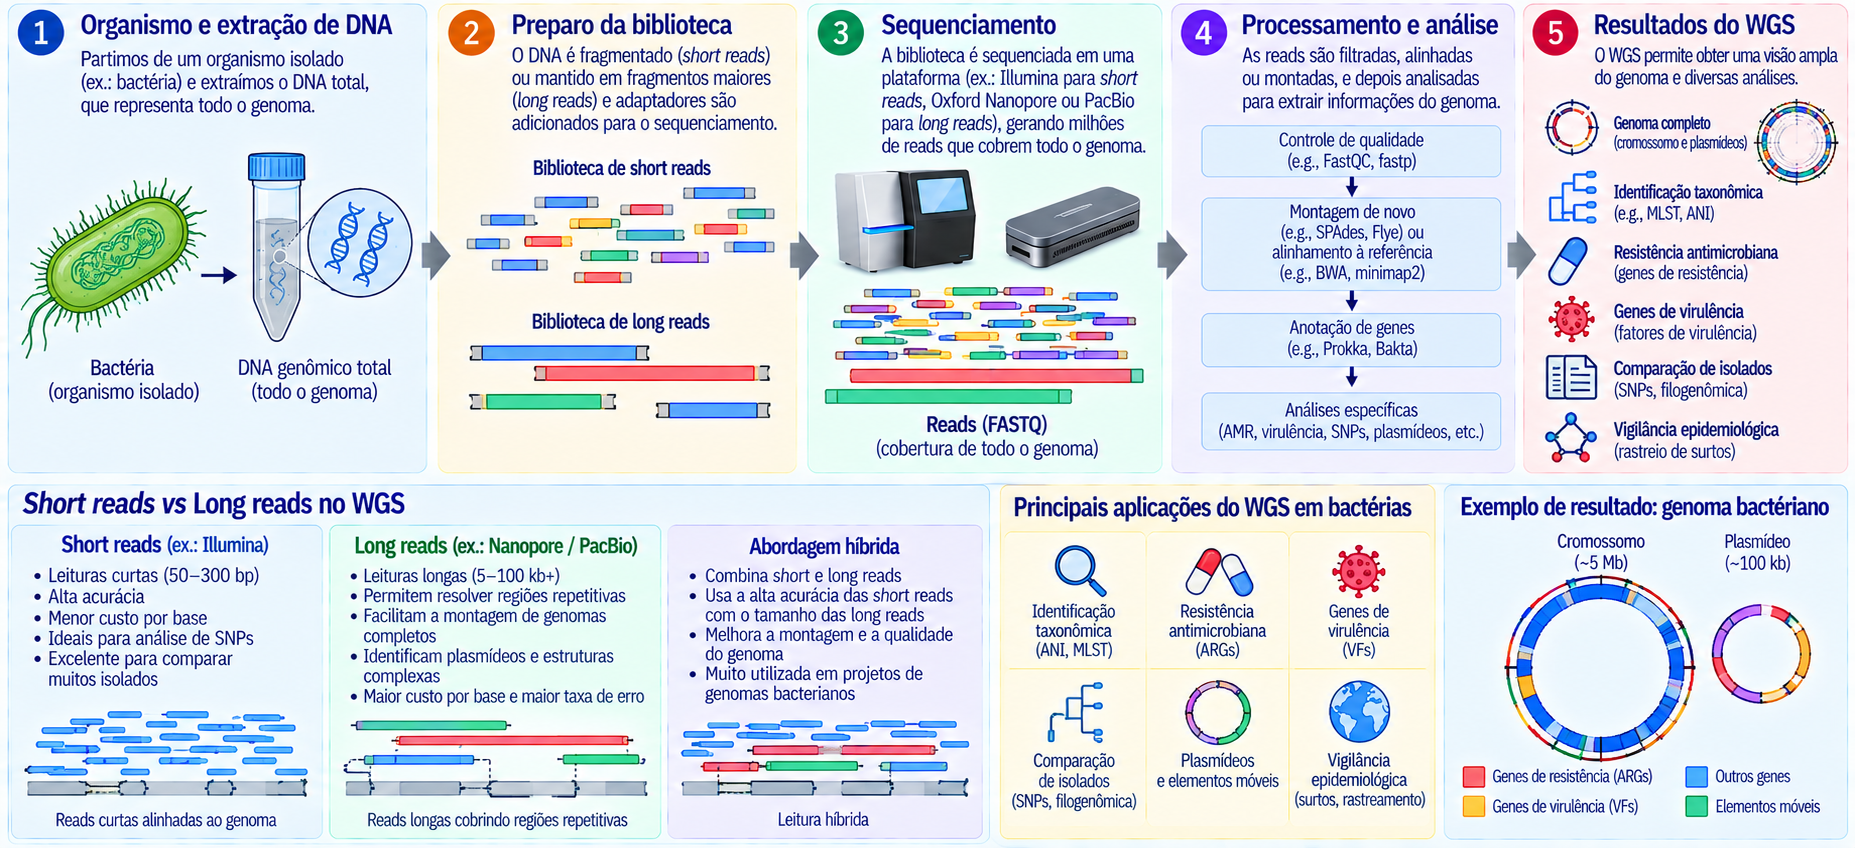
Imagine que um pesquisador queira sequenciar uma bactéria isolada de uma amostra clínica. O primeiro elemento disponível não é uma sequência de DNA, mas uma amostra física contendo células bacterianas.
O fluxo inicial poderia ser representado da seguinte maneira:
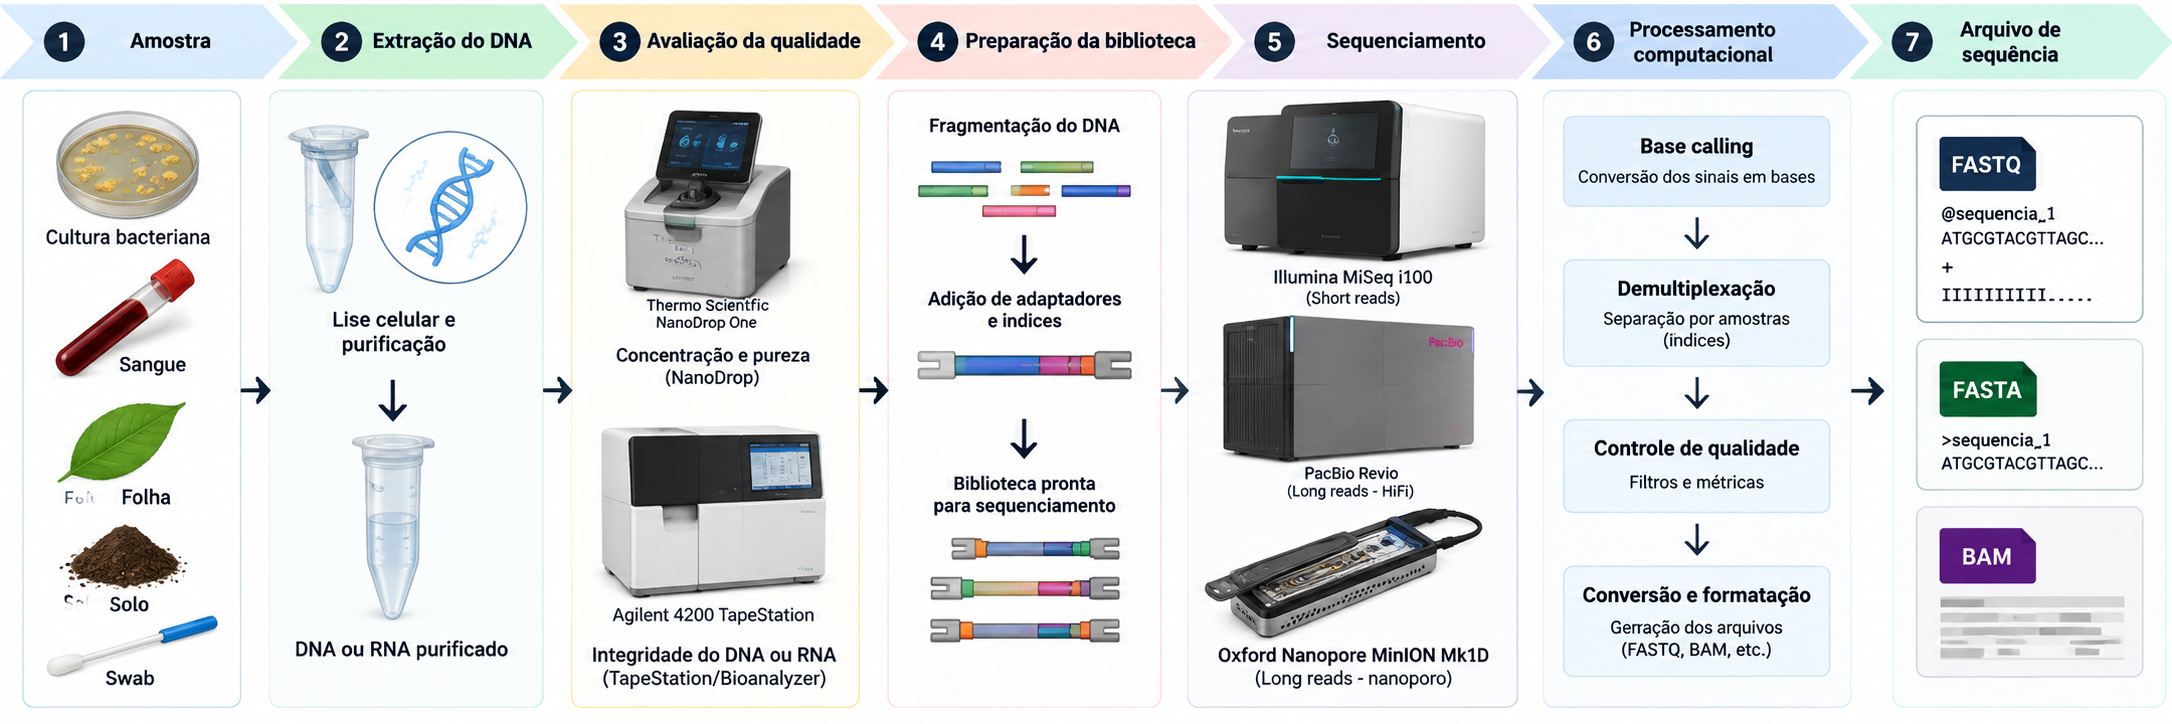
Cada etapa influencia a próxima.
Se a extração produzir DNA altamente degradado, por exemplo, uma tecnologia projetada para produzir reads extremamente longas pode não alcançar todo o seu potencial, pois as moléculas já chegarão fragmentadas ao equipamento. Da mesma forma, se houver contaminantes químicos na amostra, determinadas reações da preparação de biblioteca podem ser prejudicadas.
Isso significa que problemas observados mais tarde na bioinformática nem sempre surgiram na bioinformática. Muitas vezes, eles refletem eventos ocorridos muito antes da geração do FASTQ.
Por essa razão, um bioinformata deve compreender pelo menos os princípios básicos das etapas laboratoriais anteriores ao sequenciamento.
Extração De Dna Ou Rna
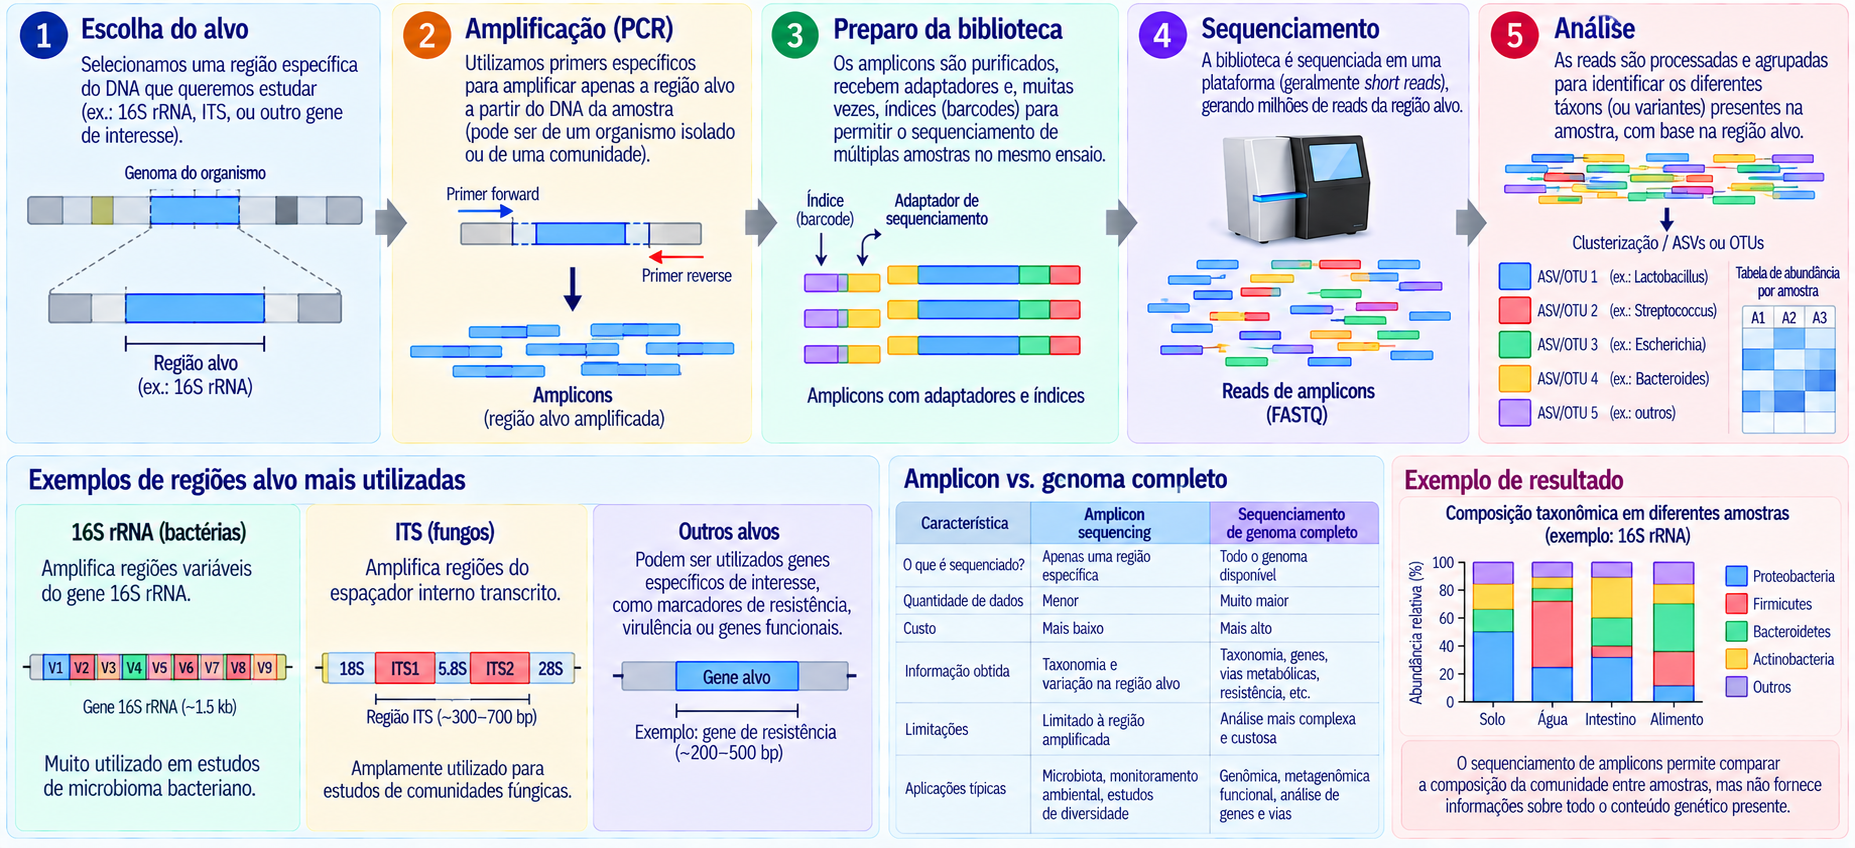
A primeira etapa fundamental é obter o ácido nucleico que será analisado. Dependendo do projeto, esse material pode ser DNA genômico, RNA total, RNA mensageiro, DNA ambiental, DNA viral, produtos de PCR ou outras moléculas.
A extração procura romper células ou partículas, liberar o material genético e separá-lo de proteínas, lipídios, sais e outras moléculas presentes na amostra.
O resultado ideal depende do objetivo experimental. Em alguns projetos de short reads, fragmentação moderada do DNA pode não representar um grande problema, pois o DNA será fragmentado posteriormente de qualquer forma. Em projetos voltados a long reads, entretanto, preservar moléculas muito grandes pode ser determinante.
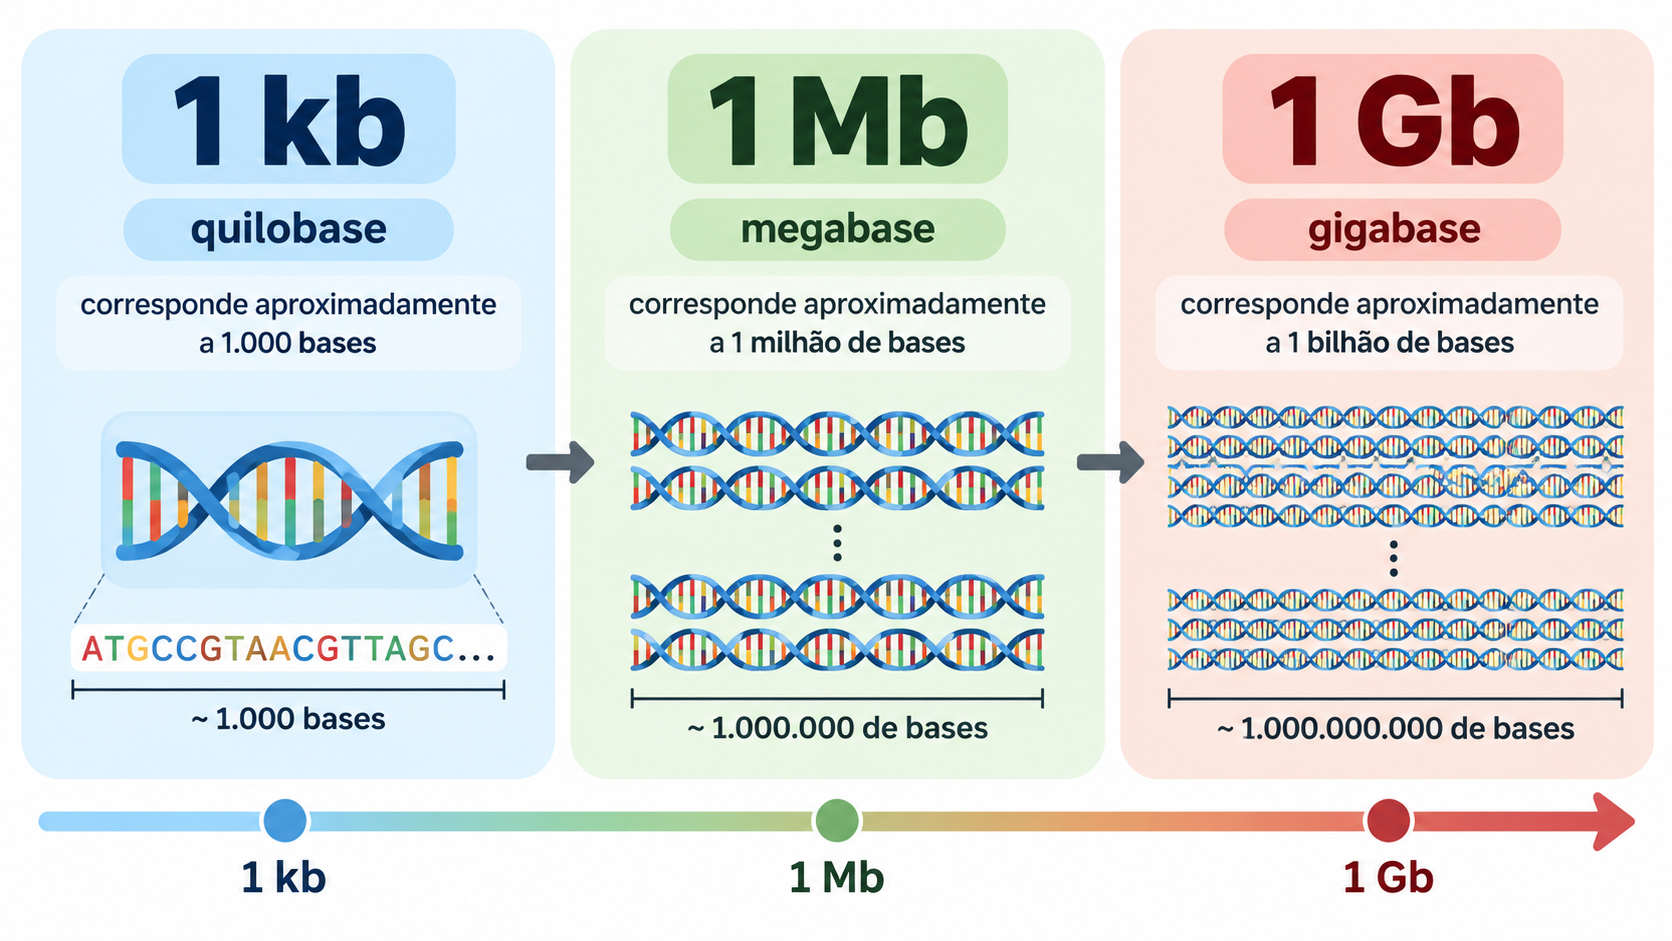
Isso ocorre porque nenhuma tecnologia consegue gerar uma read maior que a molécula efetivamente apresentada ao sistema. Se todo o DNA estiver quebrado em fragmentos de 5 kilobases, não será possível esperar uma grande quantidade de reads de 50 ou 100 kilobases simplesmente porque essas moléculas longas já não existem na amostra.
No caso do RNA, a situação pode ser ainda mais sensível, pois RNA é uma molécula relativamente suscetível à degradação. Um RNA degradado pode distorcer análises de expressão gênica ou dificultar a reconstrução de transcritos completos.
Quantidade, Pureza E Integridade
Antes de preparar a biblioteca, normalmente é necessário avaliar a qualidade do material extraído. Essa avaliação pode envolver três dimensões principais: quantidade, pureza e integridade.
A quantidade responde a uma pergunta simples: quanto DNA ou RNA existe na amostra?
Diferentes protocolos exigem quantidades mínimas de material. Uma concentração muito baixa pode comprometer a eficiência da preparação da biblioteca ou obrigar o uso de etapas adicionais de amplificação.
A pureza procura verificar se substâncias indesejadas acompanharam o ácido nucleico durante a extração. Sais, proteínas, fenol, etanol residual e outros compostos podem interferir em reações enzimáticas.
A integridade, por sua vez, descreve o estado físico das moléculas. DNA muito fragmentado possui menor comprimento médio. RNA degradado apresenta perda progressiva de moléculas intactas.
Essas três propriedades não são equivalentes. Uma amostra pode possuir muito DNA, porém altamente degradado. Pode também possuir DNA íntegro, porém contaminado. Pode ainda possuir excelente pureza, mas concentração insuficiente.
Por isso, “ter DNA” não significa automaticamente “ter uma boa amostra para sequenciamento”.
O Que É Uma Biblioteca De Sequenciamento?
Depois da extração e do controle de qualidade, o material precisa ser preparado para a plataforma que será utilizada. Essa preparação produz aquilo que chamamos de biblioteca de sequenciamento.
A palavra biblioteca pode causar confusão para quem está começando, pois na computação usamos “library” para falar de bibliotecas de software. Aqui o significado é completamente diferente.
Uma biblioteca de sequenciamento é uma coleção de moléculas preparadas de forma que possam ser reconhecidas e processadas pelo equipamento.
O DNA extraído diretamente de uma célula geralmente não é simplesmente colocado no sequenciador sem modificações. Dependendo da plataforma e do protocolo, ele pode ser fragmentado, reparado, selecionado por tamanho, amplificado e ligado a sequências artificiais.
Essas sequências artificiais são fundamentais porque permitem que as moléculas interajam com os componentes da plataforma.
Podemos imaginar o processo de maneira simplificada:
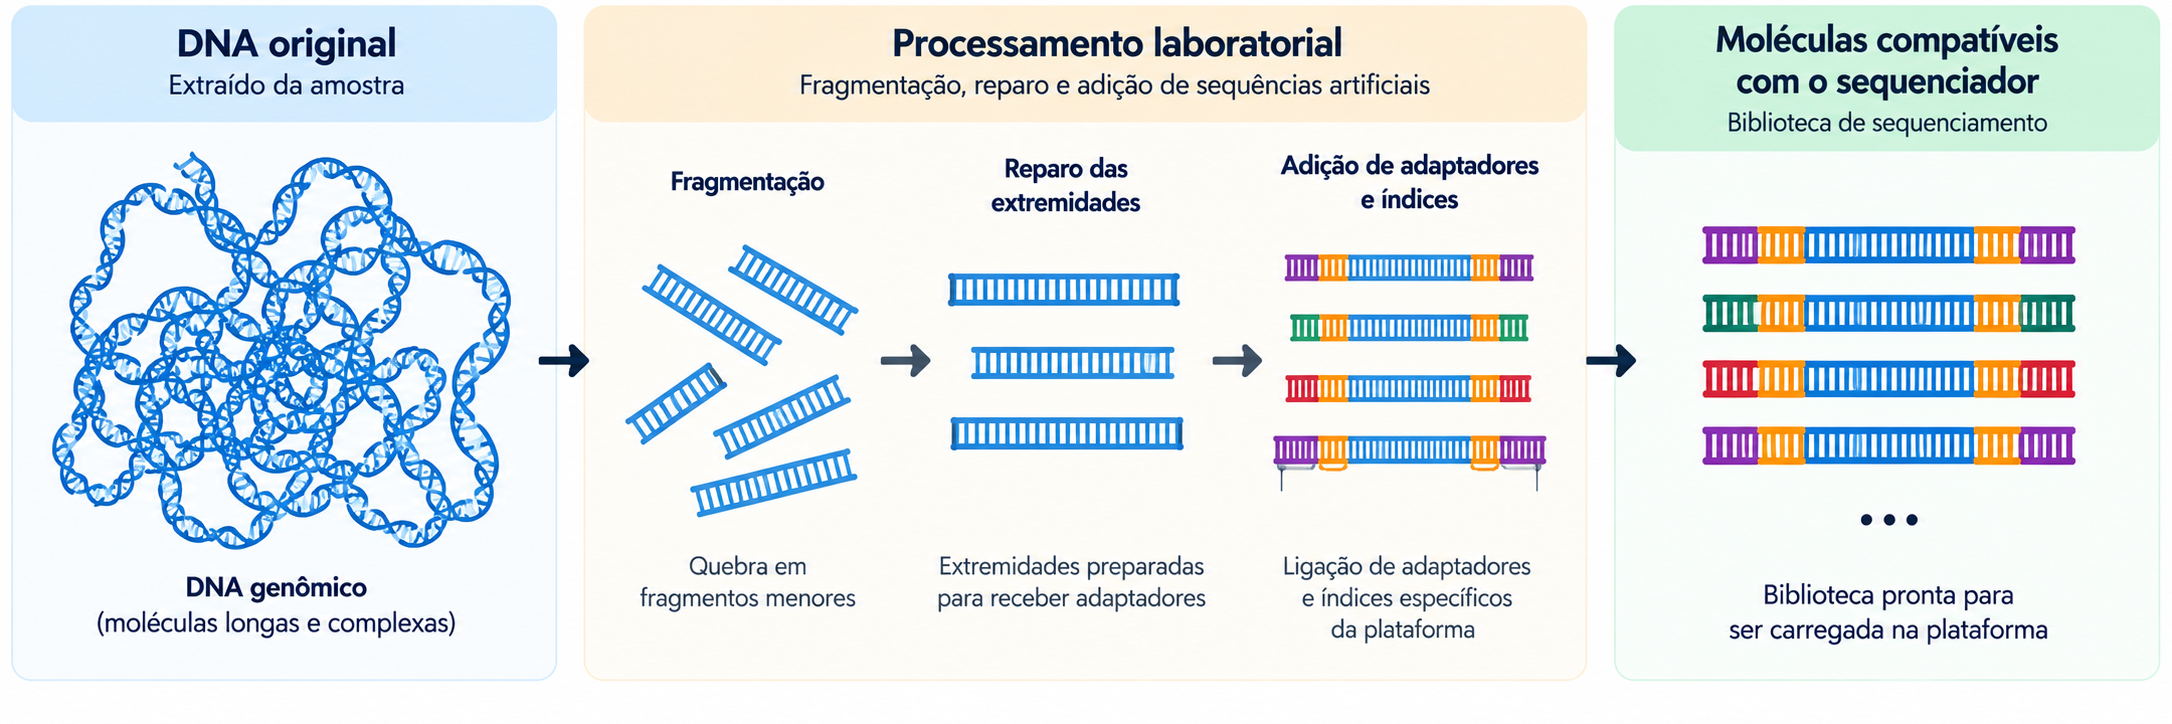
O resultado dessa preparação é a biblioteca.
Diferentes plataformas exigem bibliotecas diferentes. Isso significa que a preparação realizada para uma corrida Illumina não é necessariamente igual à realizada para PacBio ou Oxford Nanopore.
O Que São Adaptadores?
Adaptadores são pequenas sequências artificiais ligadas às moléculas durante a preparação da biblioteca.
Eles não fazem parte originalmente do genoma do organismo estudado. São introduzidos porque desempenham funções técnicas necessárias ao sequenciamento.
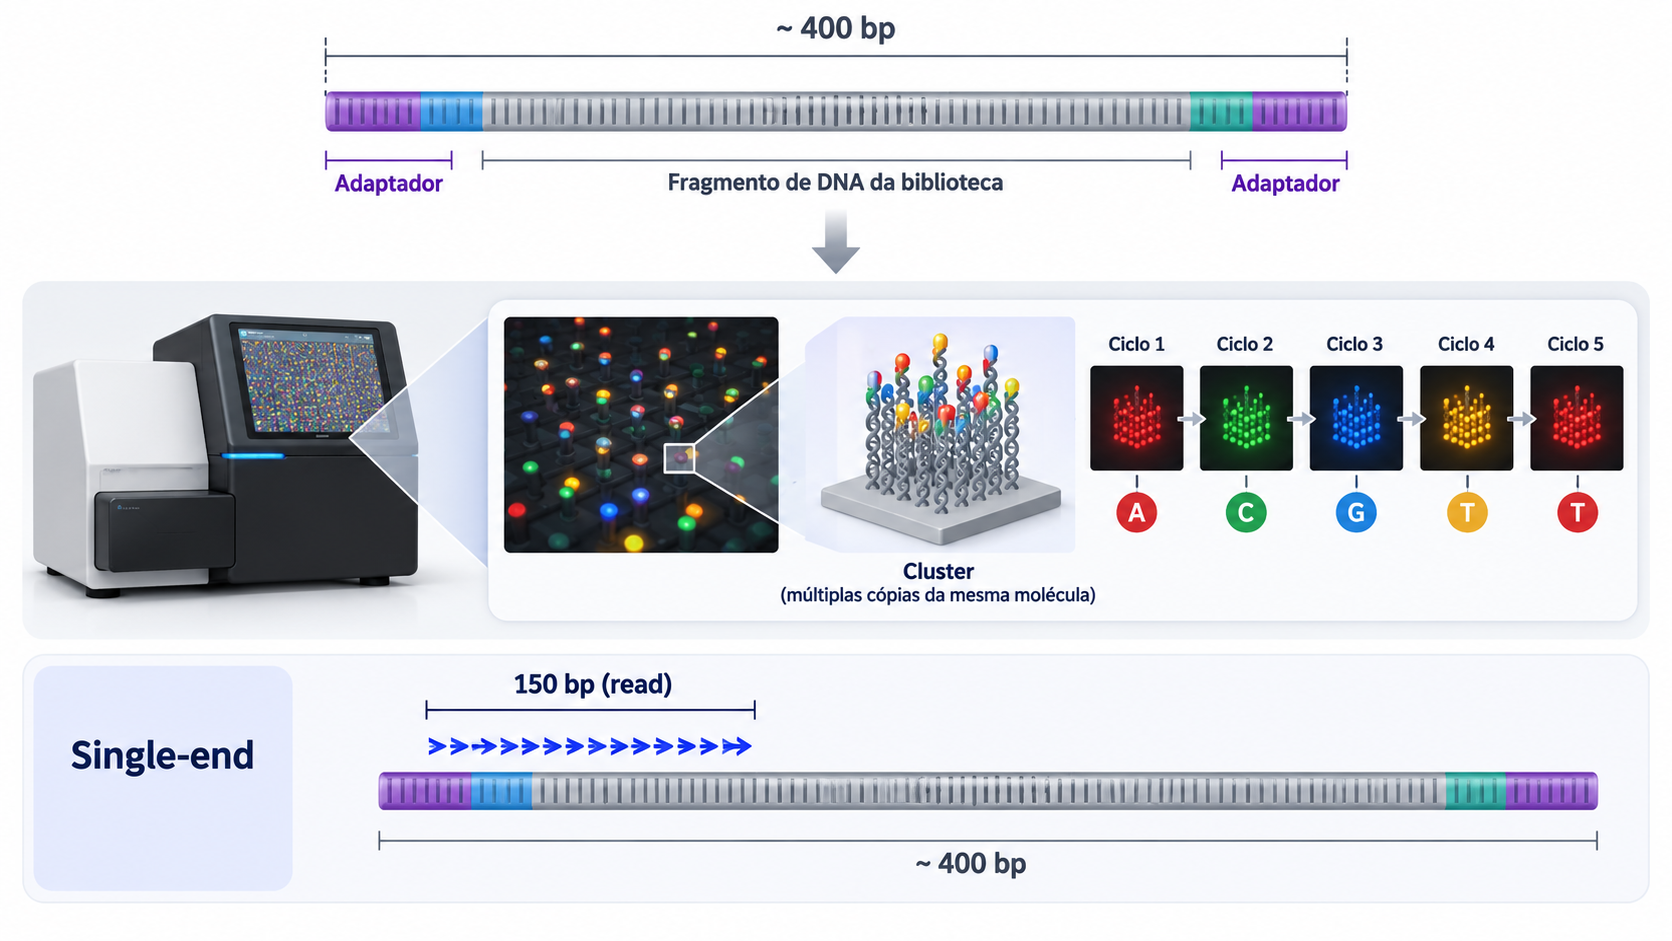
Dependendo do protocolo, os adaptadores podem permitir a ligação do fragmento ao sistema de sequenciamento, servir como regiões reconhecidas por primers, incorporar índices de amostras ou permitir determinadas etapas de amplificação.
Imagine um fragmento biológico:
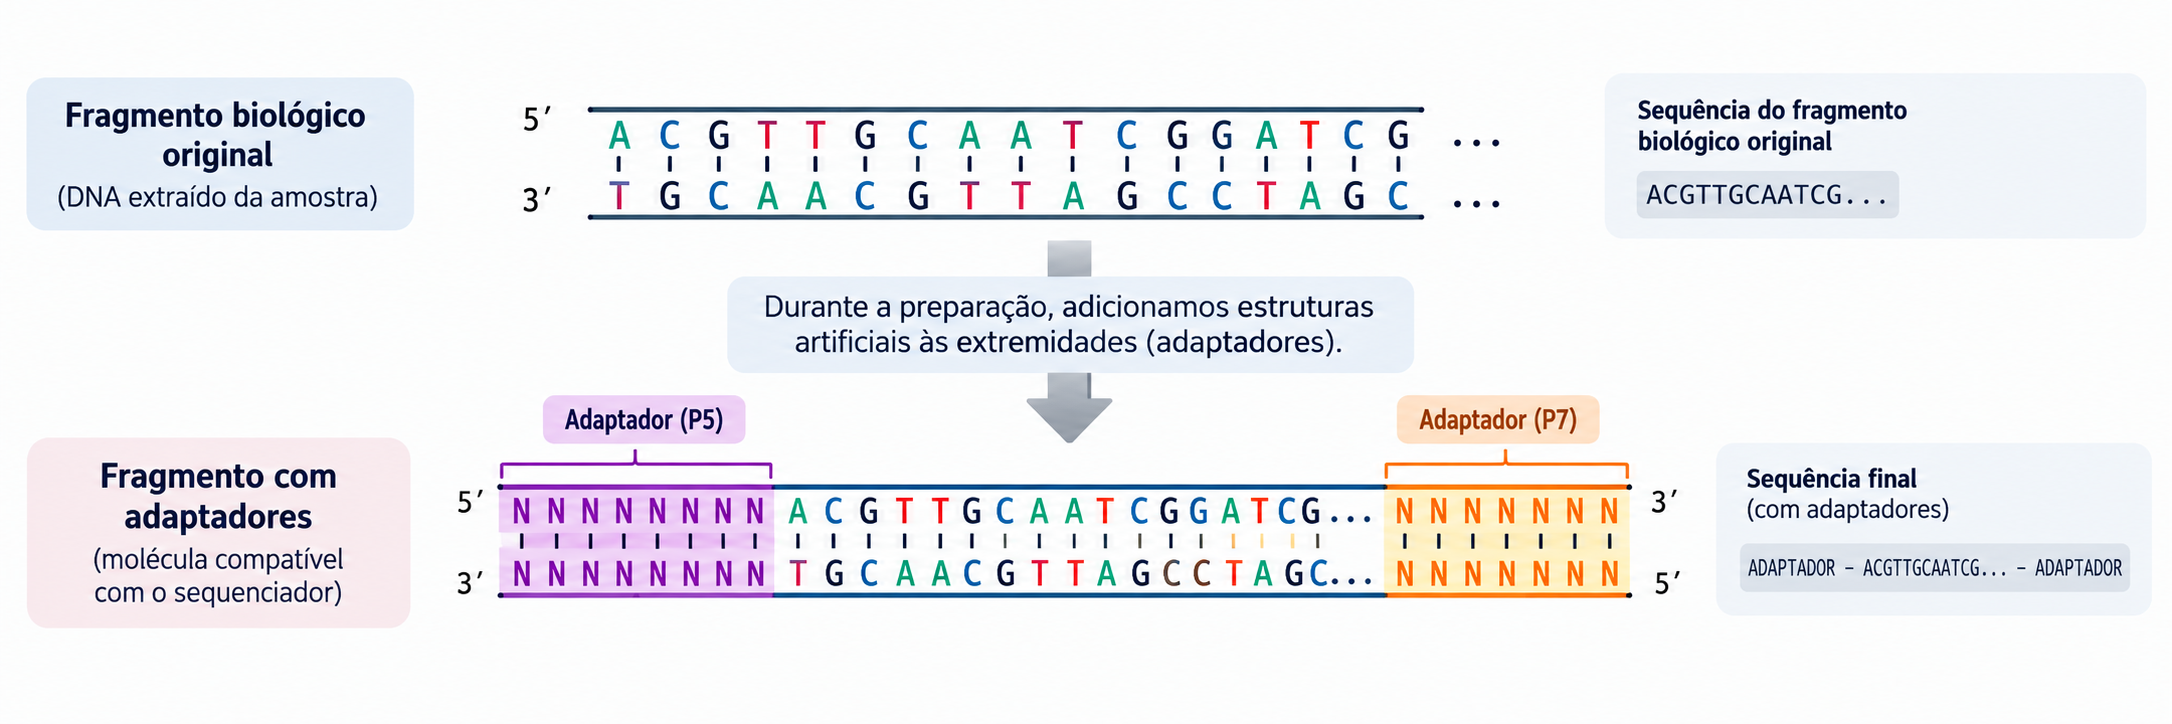
O equipamento precisa dessas estruturas para manipular adequadamente a molécula.
O problema aparece quando parte do adaptador também é sequenciada.
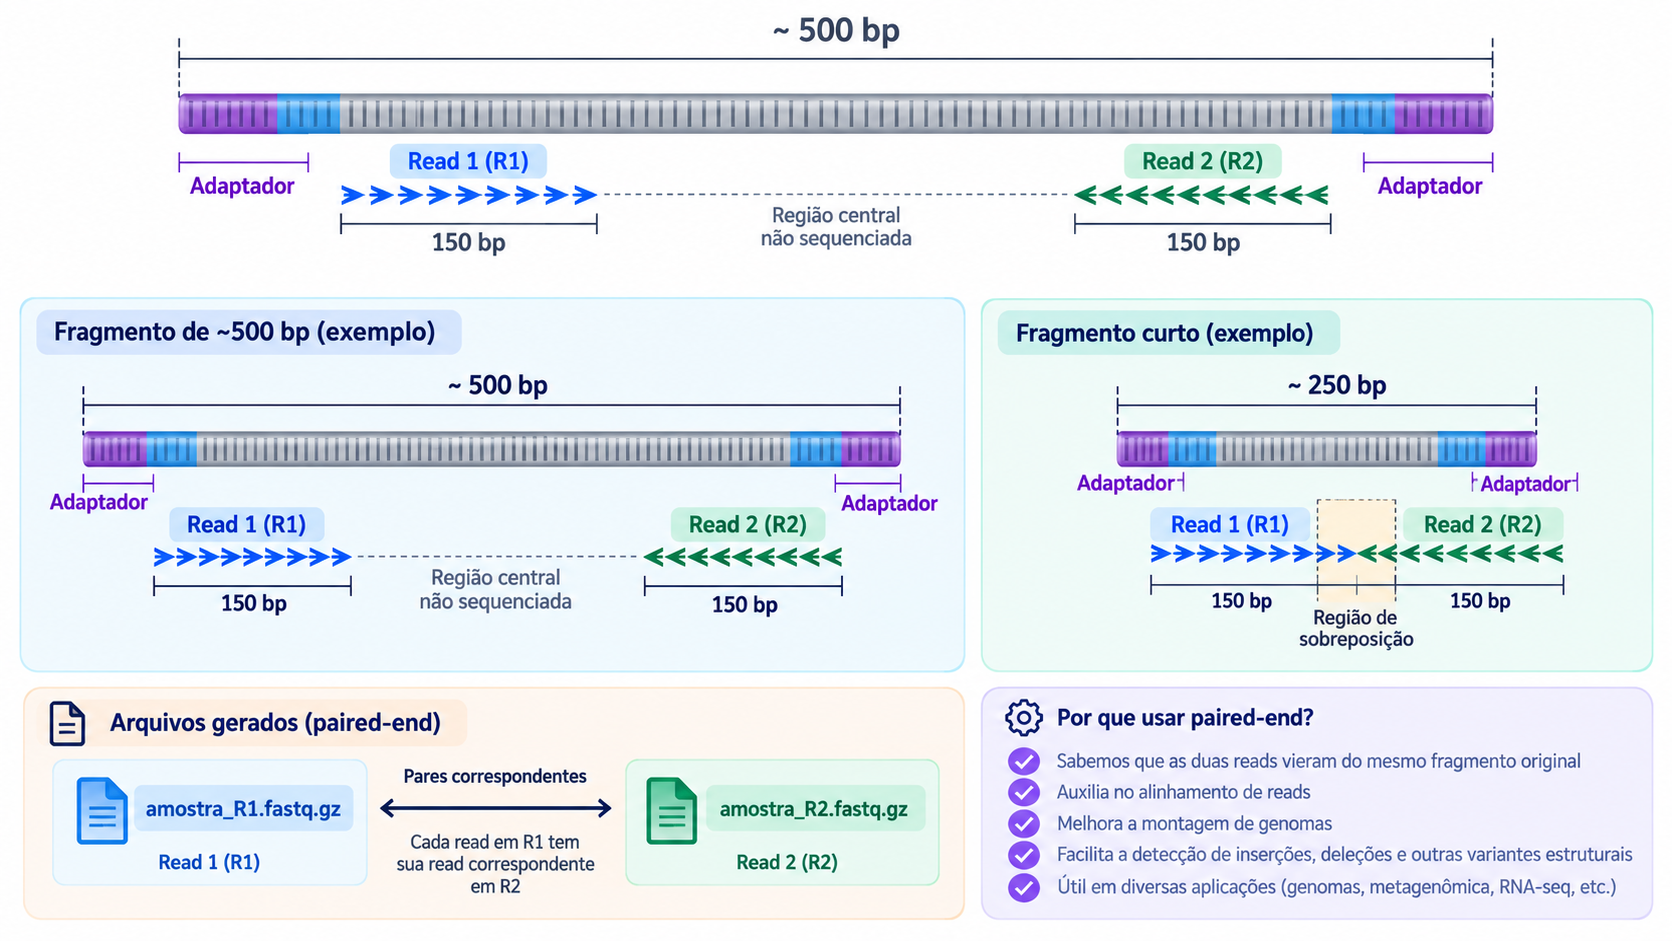
Isso pode acontecer, por exemplo, quando o fragmento de DNA é menor do que o número de ciclos de leitura realizado pelo equipamento. O sequenciador termina de atravessar a região biológica e começa a ler o adaptador.
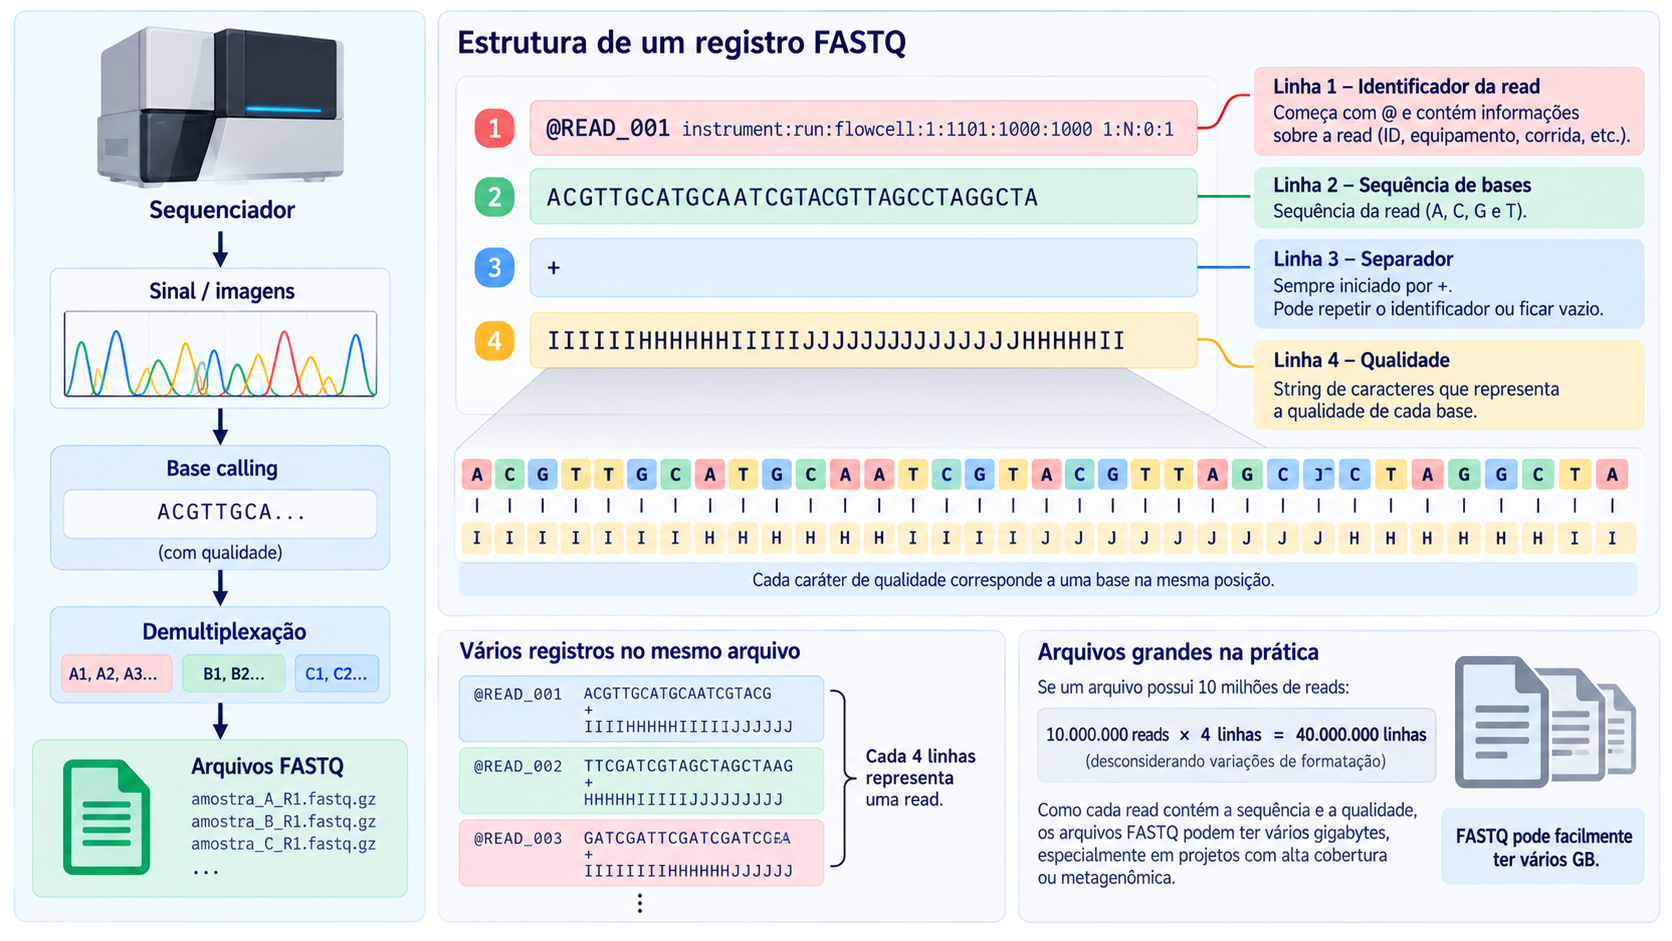
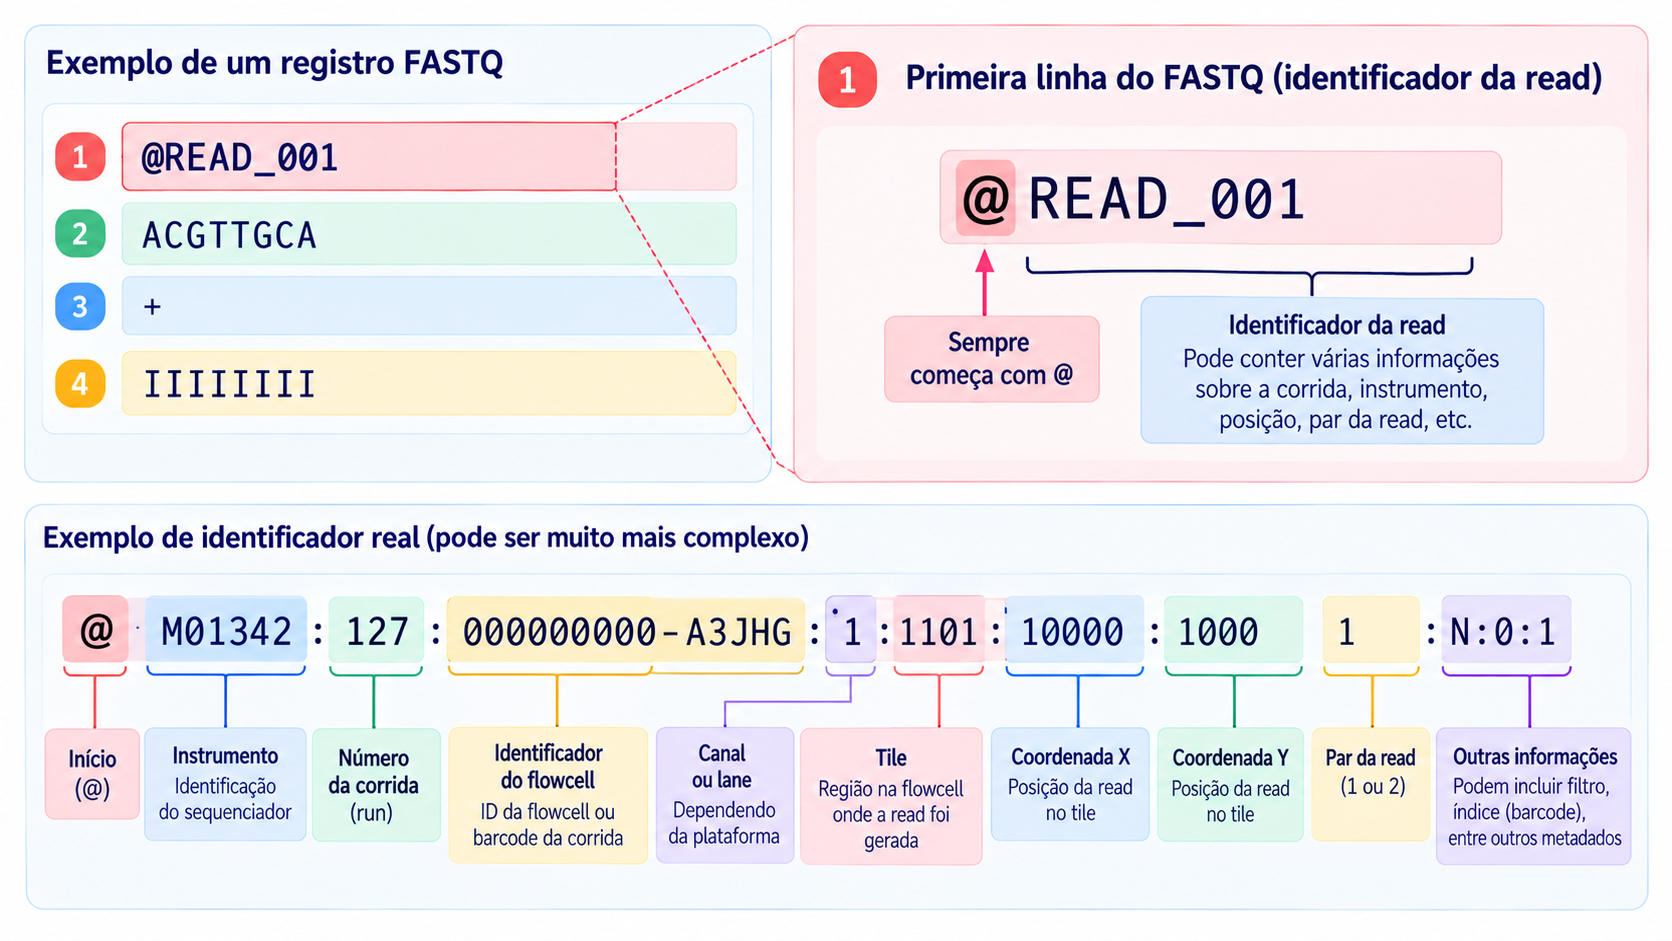
Essas sequências artificiais podem aparecer no FASTQ.
É por isso que programas como fastp ou Cutadapt conseguem detectar e remover adaptadores durante o pré-processamento.
Portanto, quando uma ferramenta de controle de qualidade aponta “adapter contamination”, isso não significa necessariamente que houve uma contaminação externa no laboratório. Muitas vezes significa simplesmente que sequências técnicas da biblioteca permaneceram dentro das reads.
Índices, Barcodes E Multiplexação
Equipamentos modernos podem gerar uma quantidade enorme de dados em uma única corrida. Frequentemente, uma única amostra não necessita de toda essa capacidade.
Suponha que um sequenciador consiga gerar centenas de milhões de reads, mas cada amostra do experimento precise apenas de alguns milhões. Utilizar uma corrida completa para cada amostra seria extremamente ineficiente e caro.
A solução é colocar várias amostras na mesma corrida.
Mas surge um problema: depois do sequenciamento, como saber qual read pertence a qual amostra?
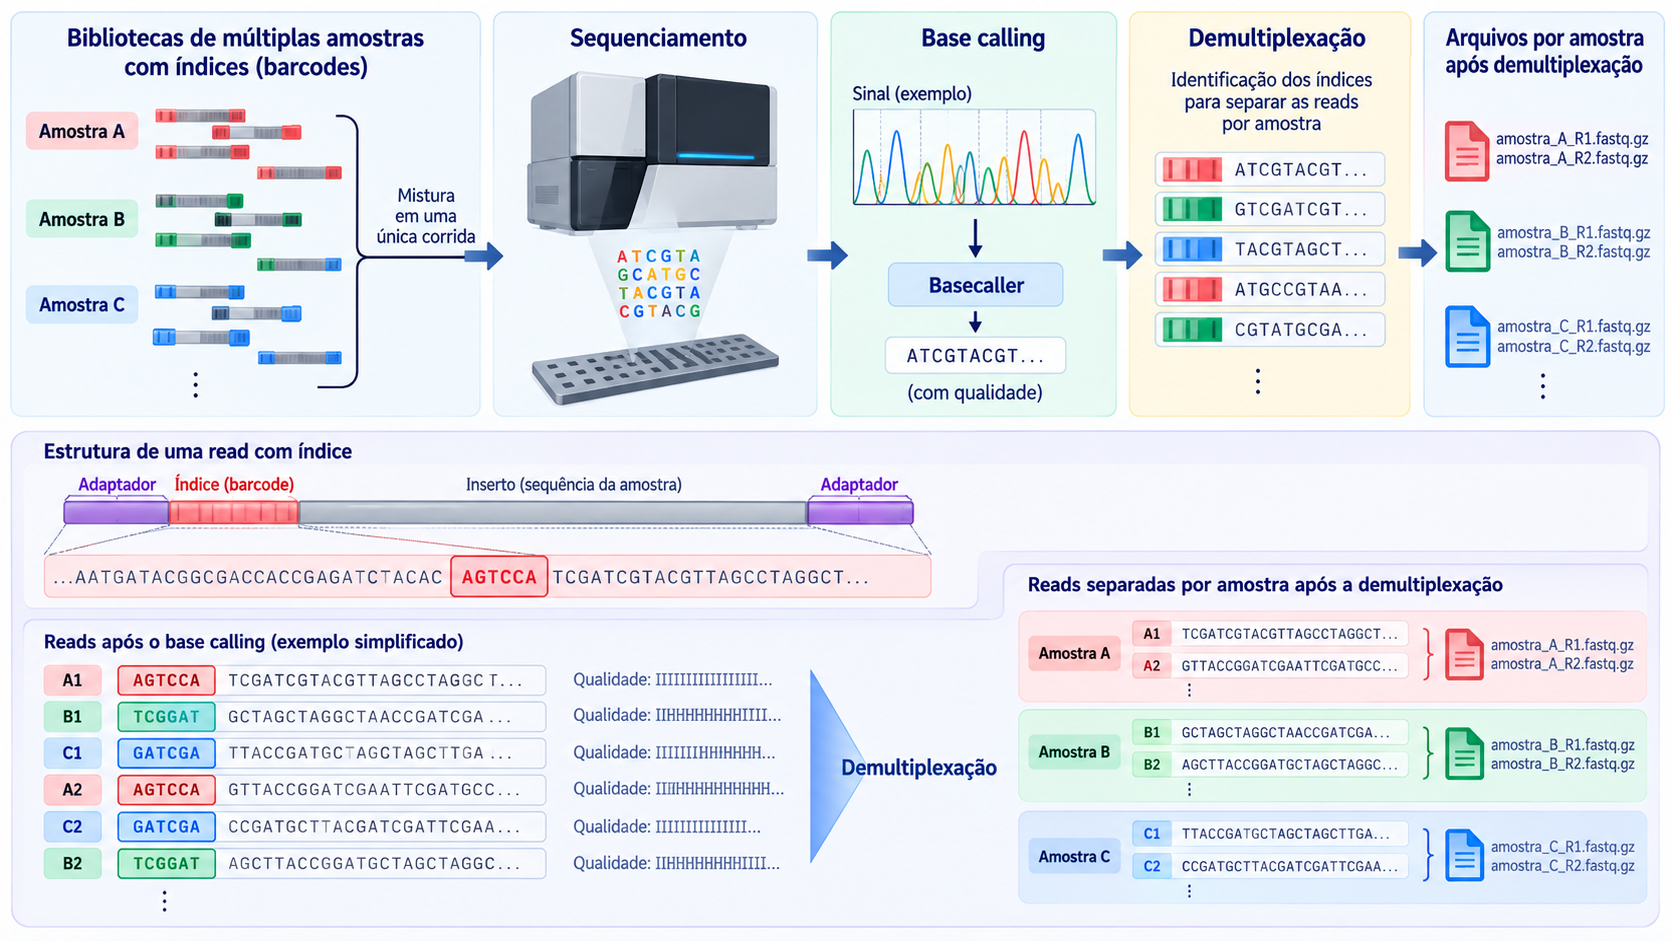
Para resolver isso, adicionam-se pequenas sequências identificadoras às bibliotecas. Essas sequências são chamadas, dependendo da plataforma e do protocolo, de índices ou barcodes.
Imagine três amostras:
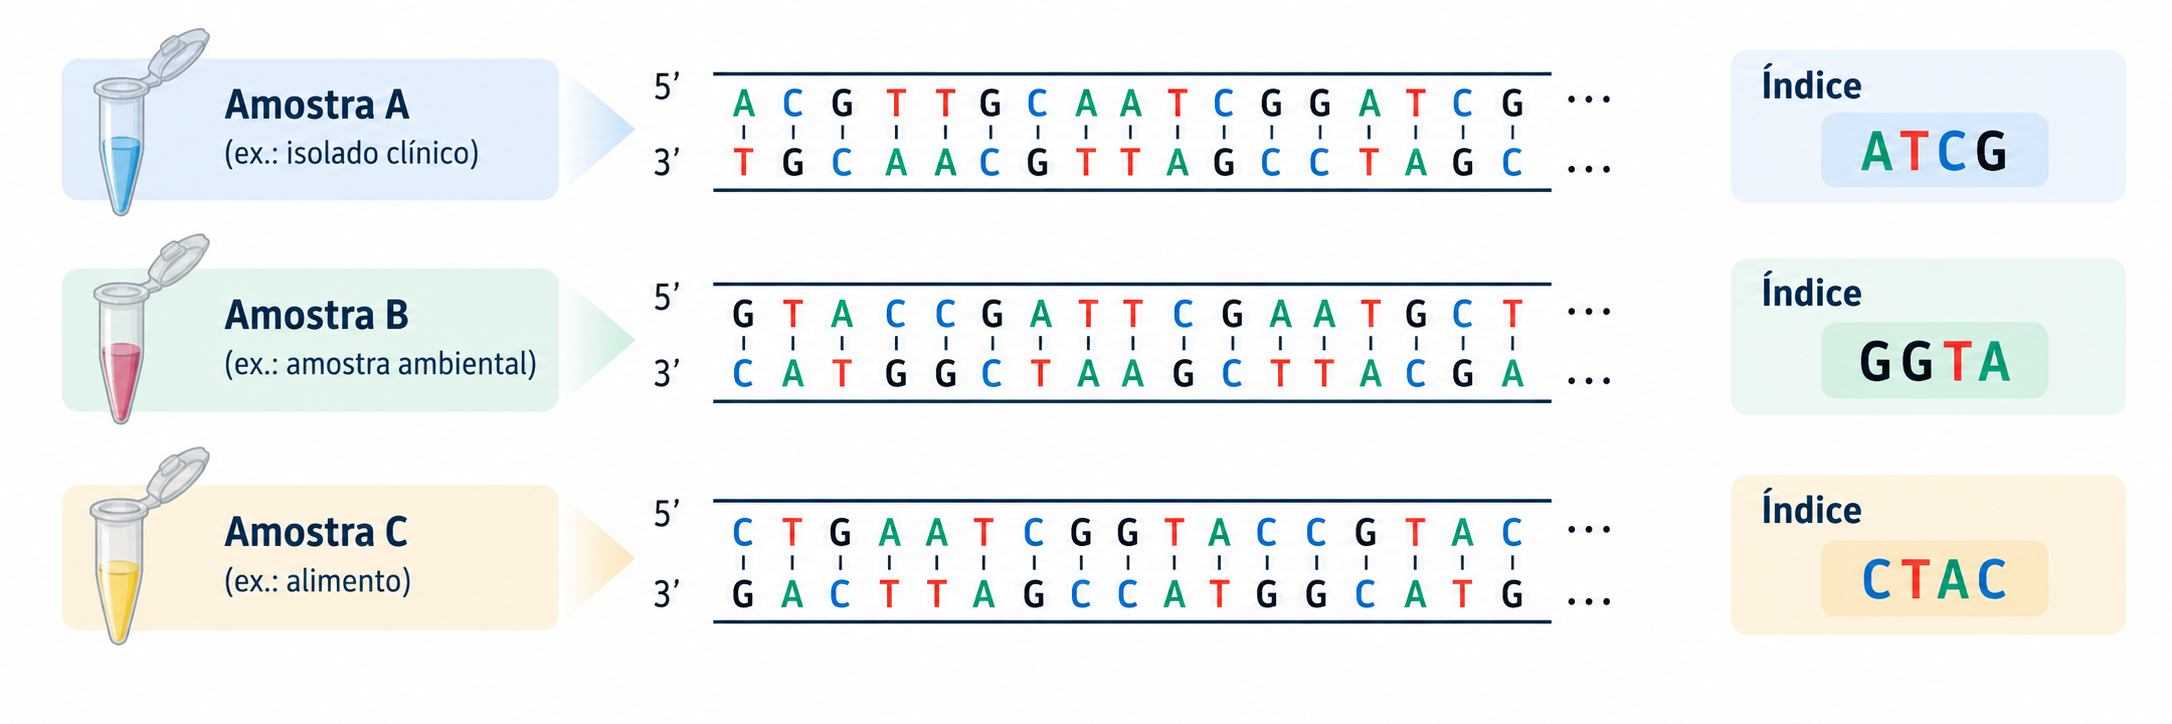
As três bibliotecas podem ser misturadas e sequenciadas juntas.
O processo de combinar múltiplas amostras em uma mesma corrida é chamado de multiplexação.
Após o sequenciamento, o software lê os índices e separa novamente os dados.
A separação é chamada de demultiplexação.
Portanto:
multiplexação = juntar amostras
demultiplexação = separar computacionalmente as reads depois da corrida
Esse conceito é extremamente importante porque explica por que um único sequenciamento pode gerar dezenas ou centenas de arquivos FASTQ diferentes.
O Que É Uma Read?
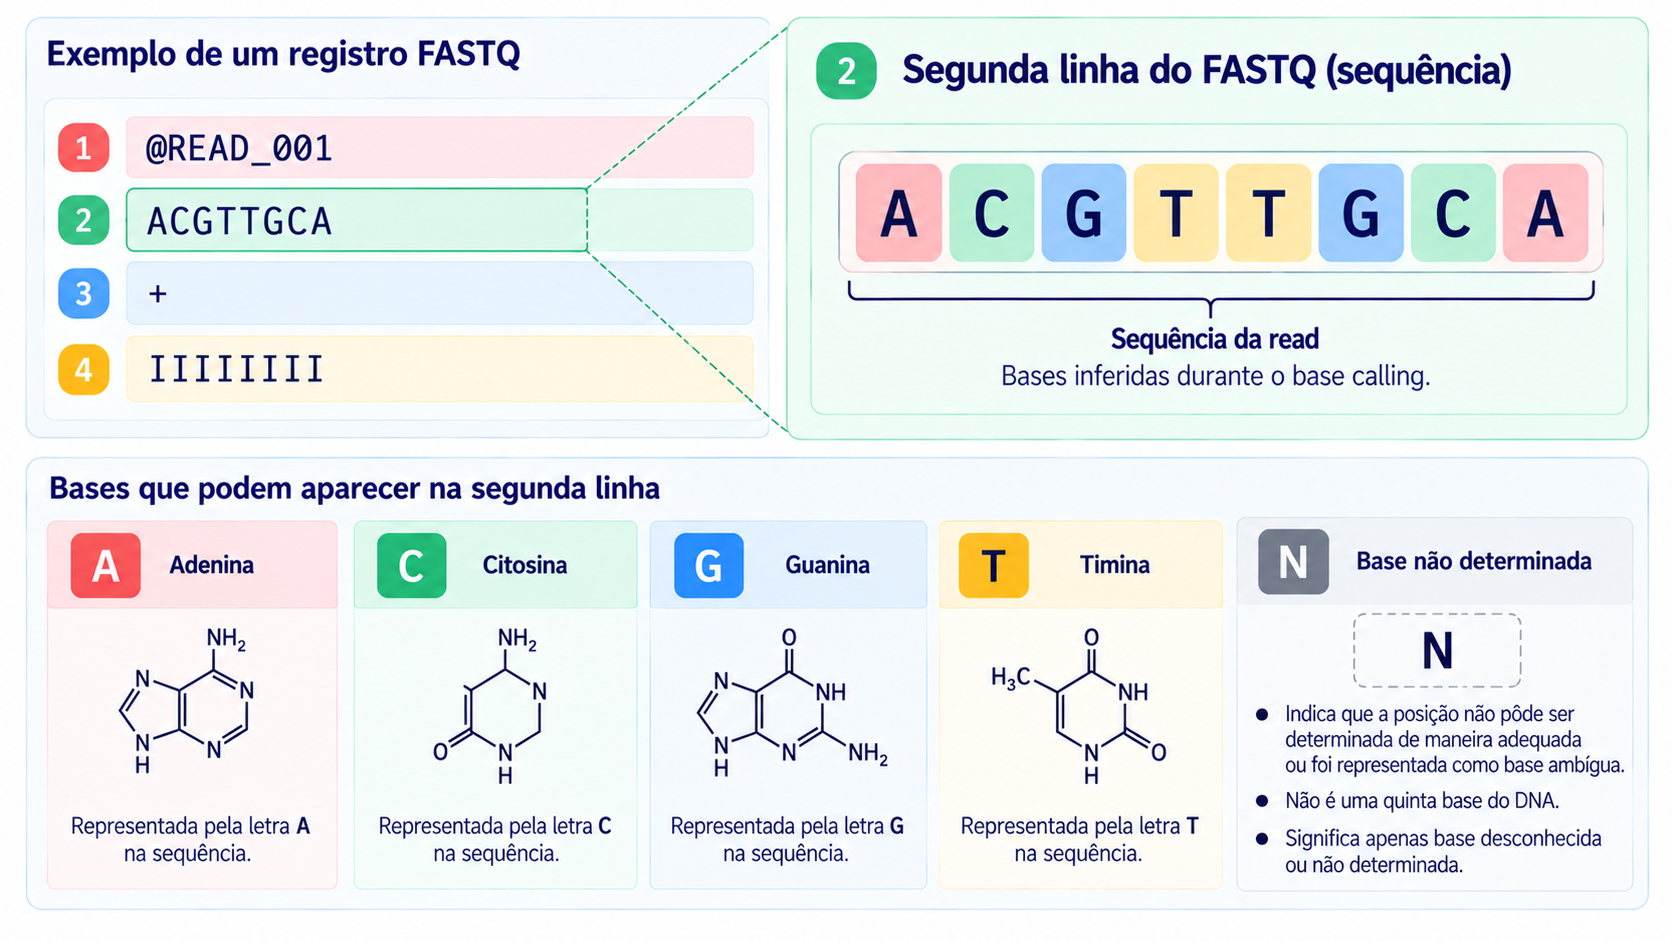
Uma vez que o sequenciador interpreta uma molécula ou fragmento, ele produz uma sequência chamada read, ou leitura.
Uma read pode ser algo como:
ACGTTGCATCGATCGGATCA
Cada read representa uma observação de uma molécula ou de parte de uma molécula.
O tamanho dessas reads varia enormemente entre tecnologias.
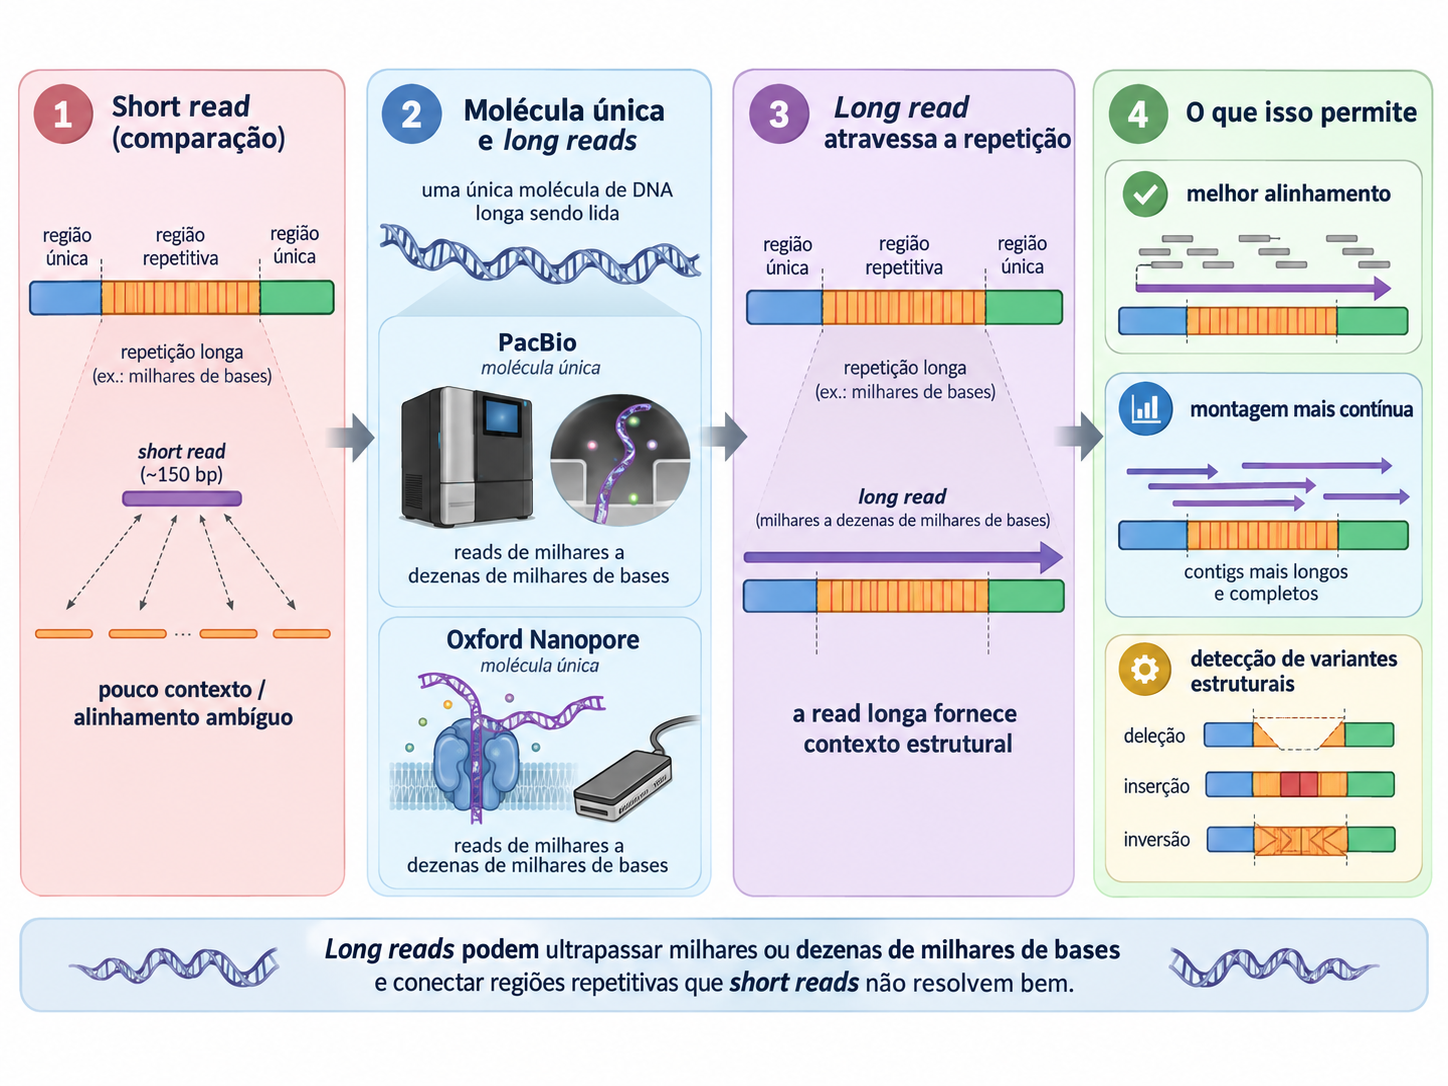
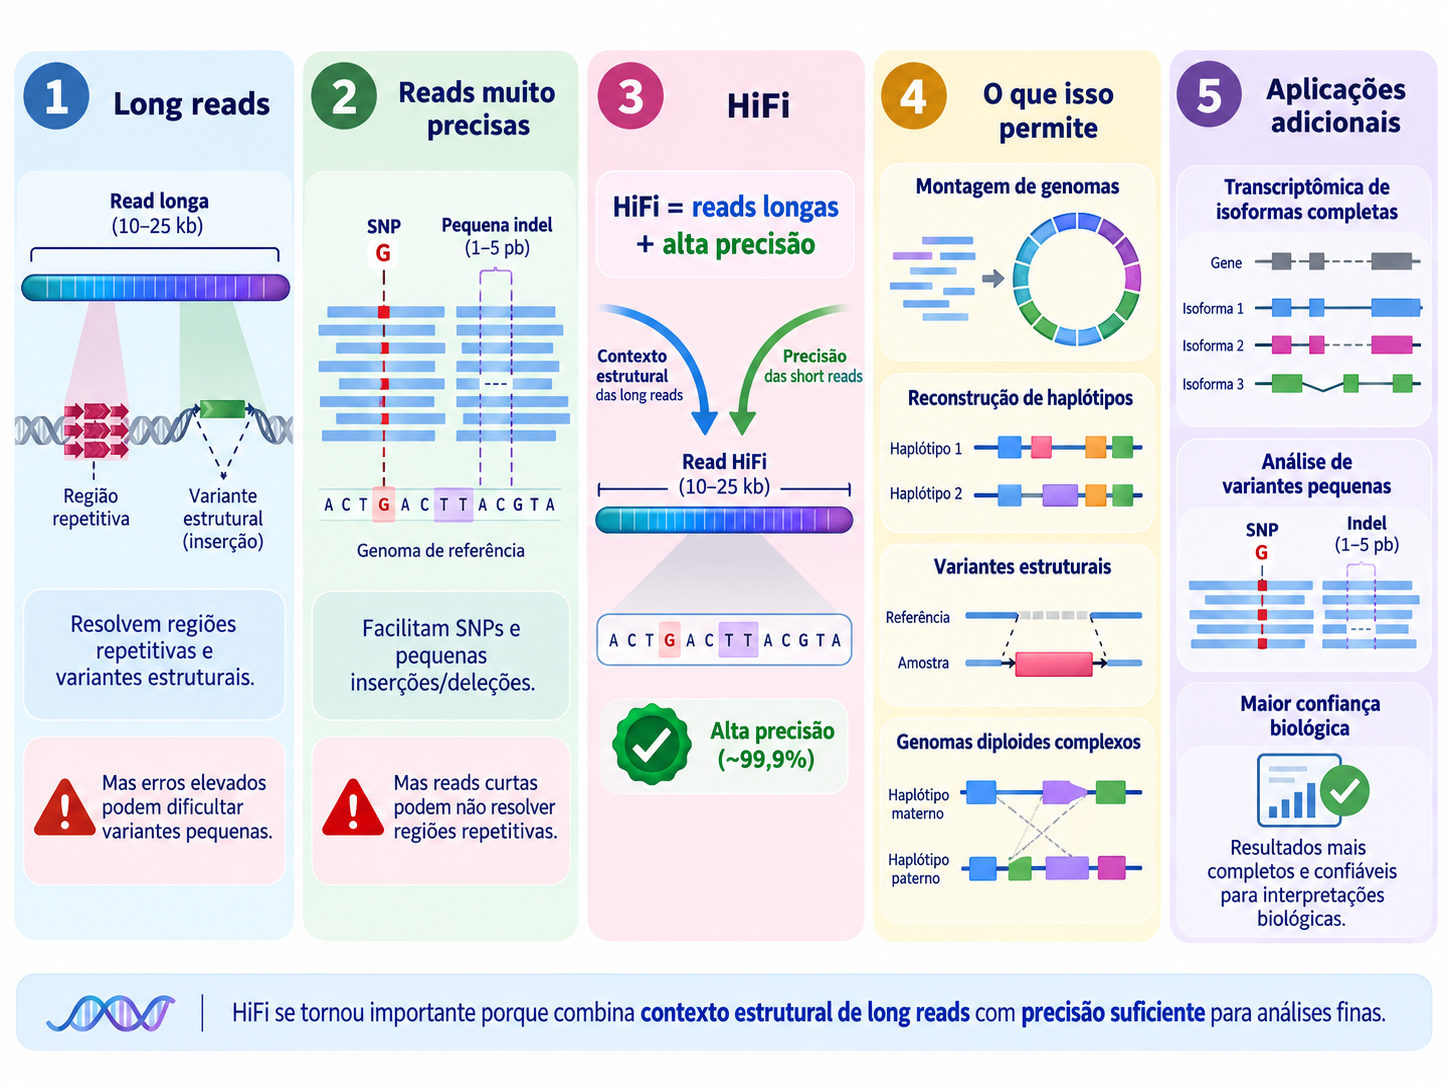
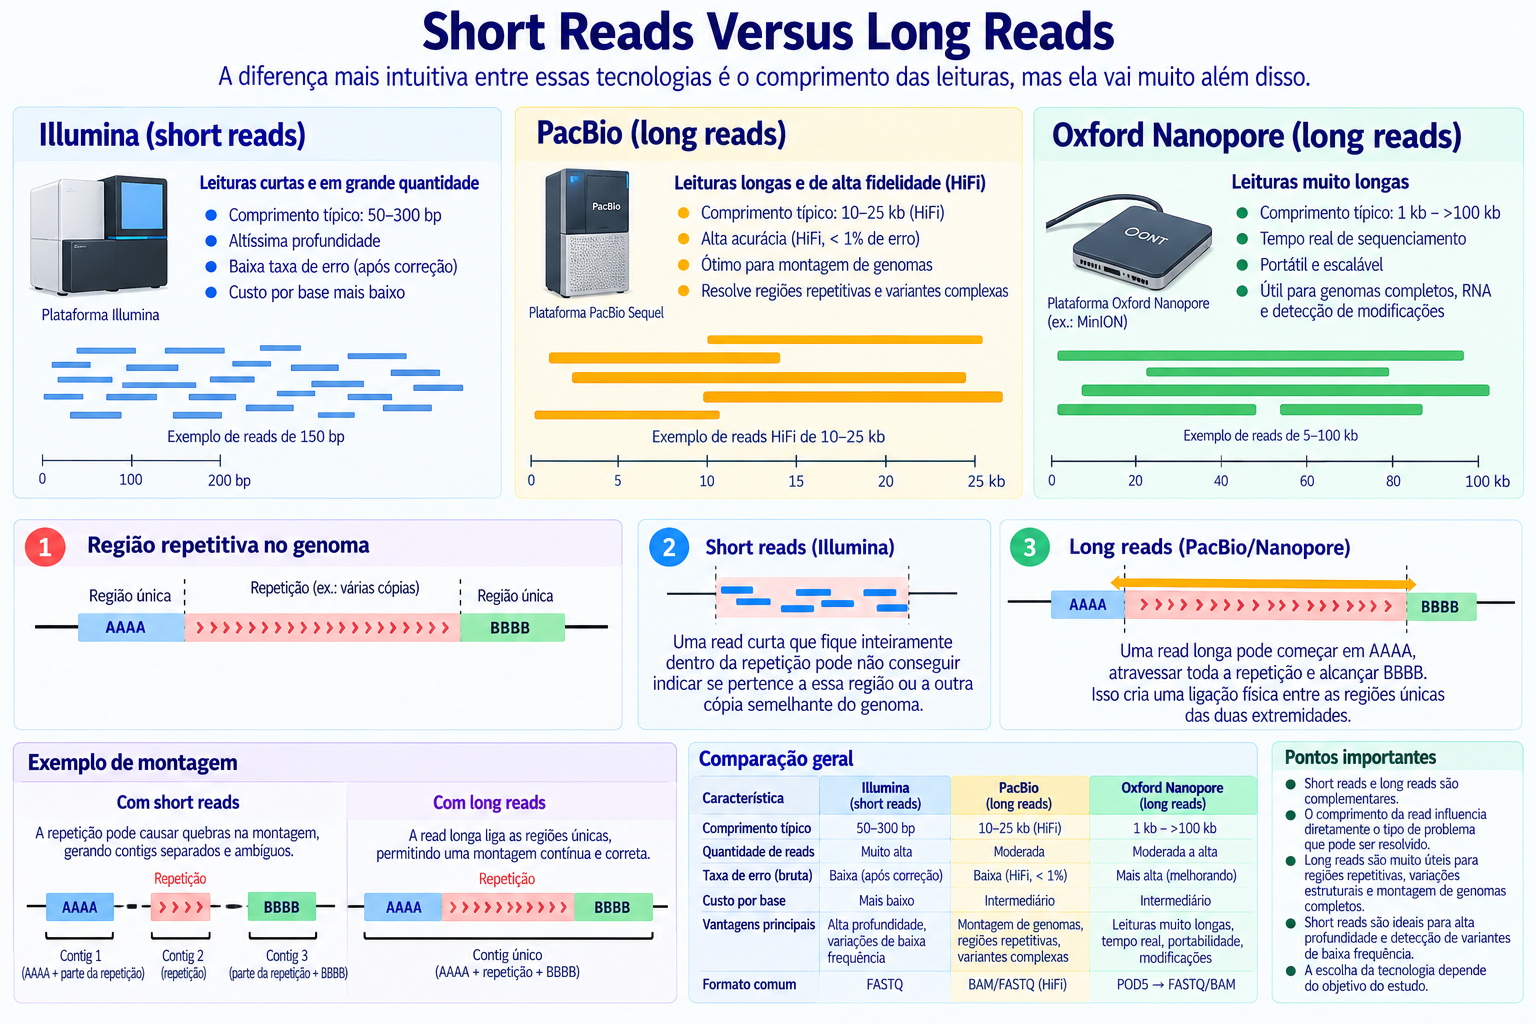
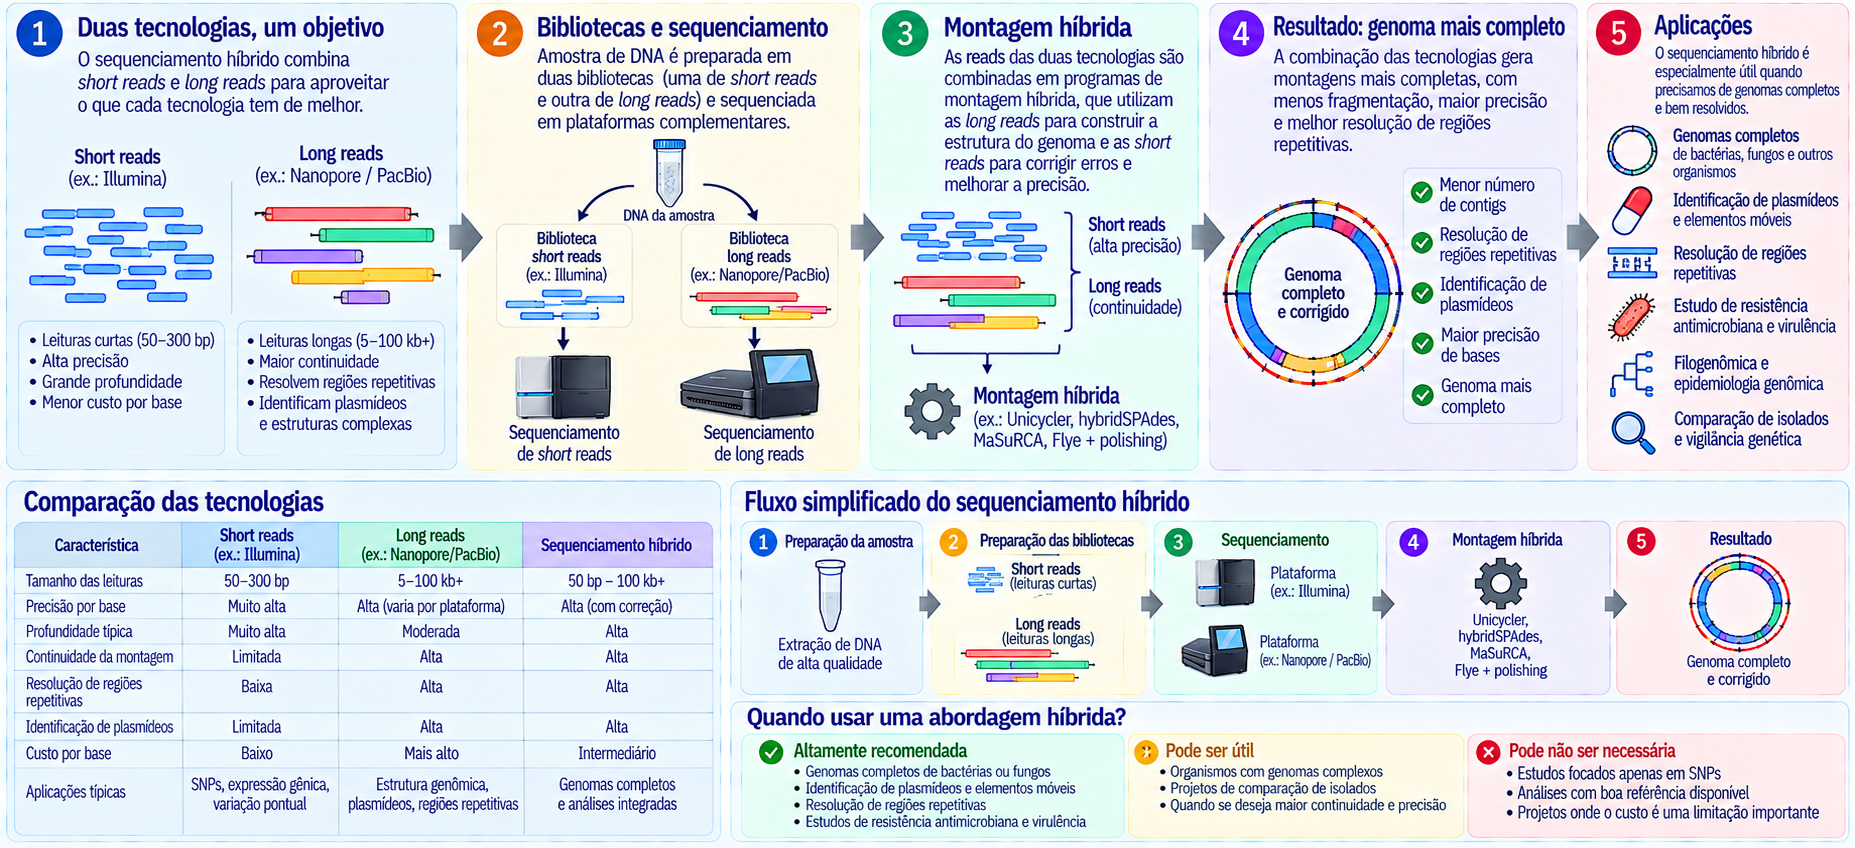
Uma plataforma de short reads pode produzir milhões ou bilhões de reads com cerca de 50 a 300 bases. Uma plataforma de long reads pode produzir sequências com milhares, dezenas de milhares ou até centenas de milhares de bases.
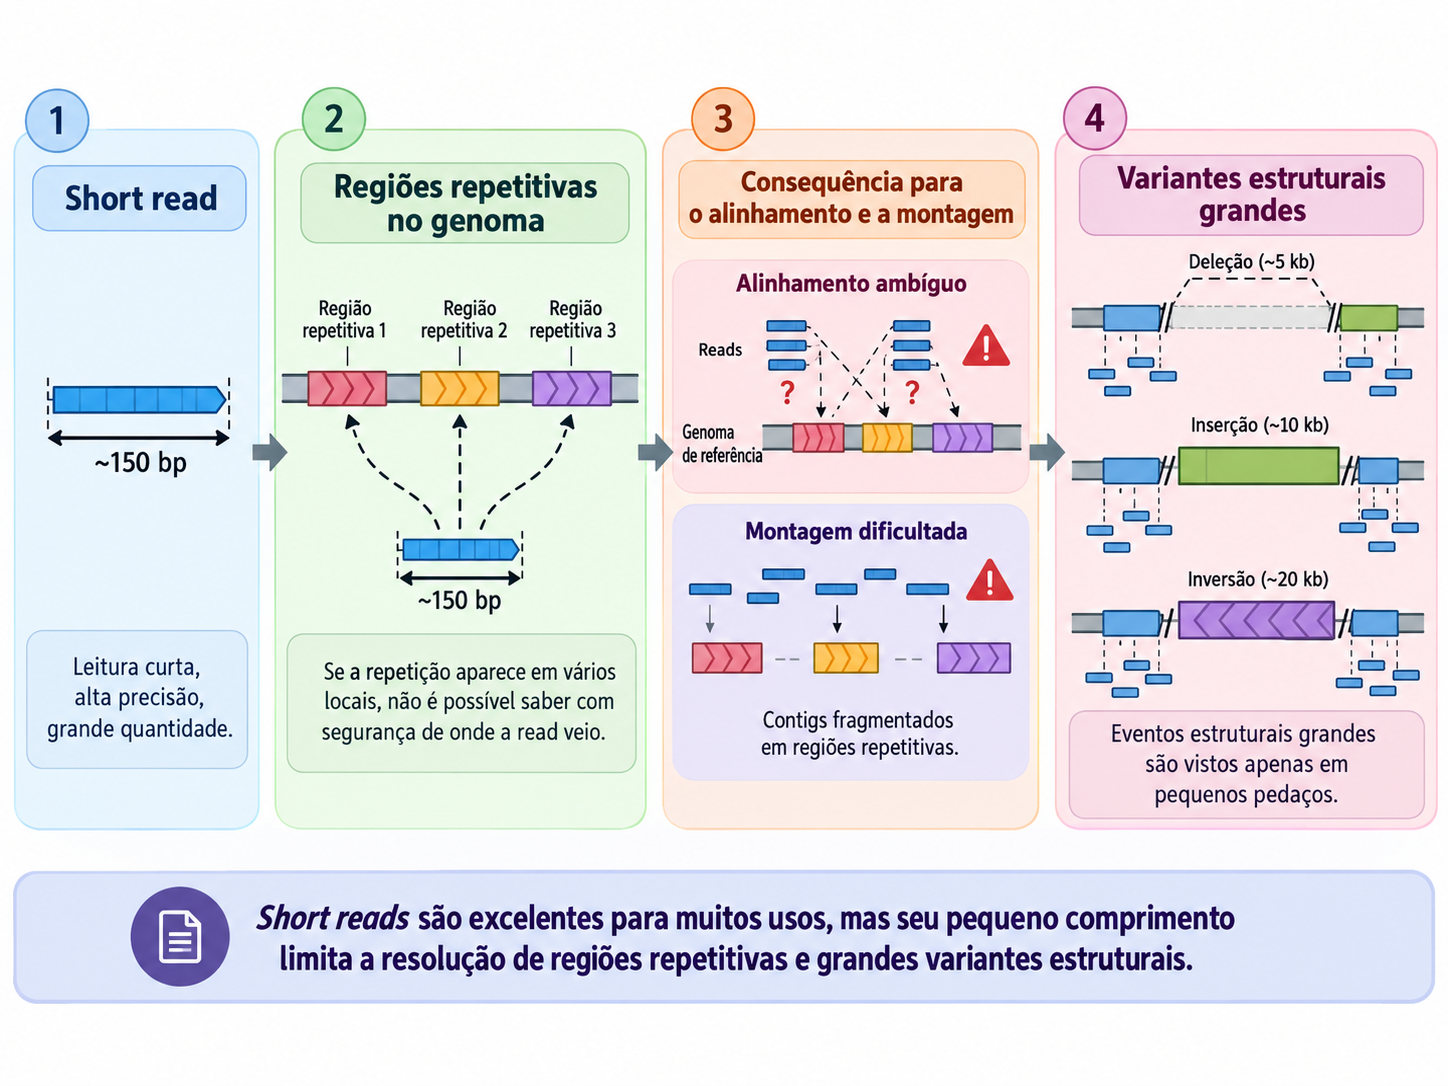
Esse comprimento é importante porque determina quanta informação estrutural existe em cada observação.
Considere duas reads:
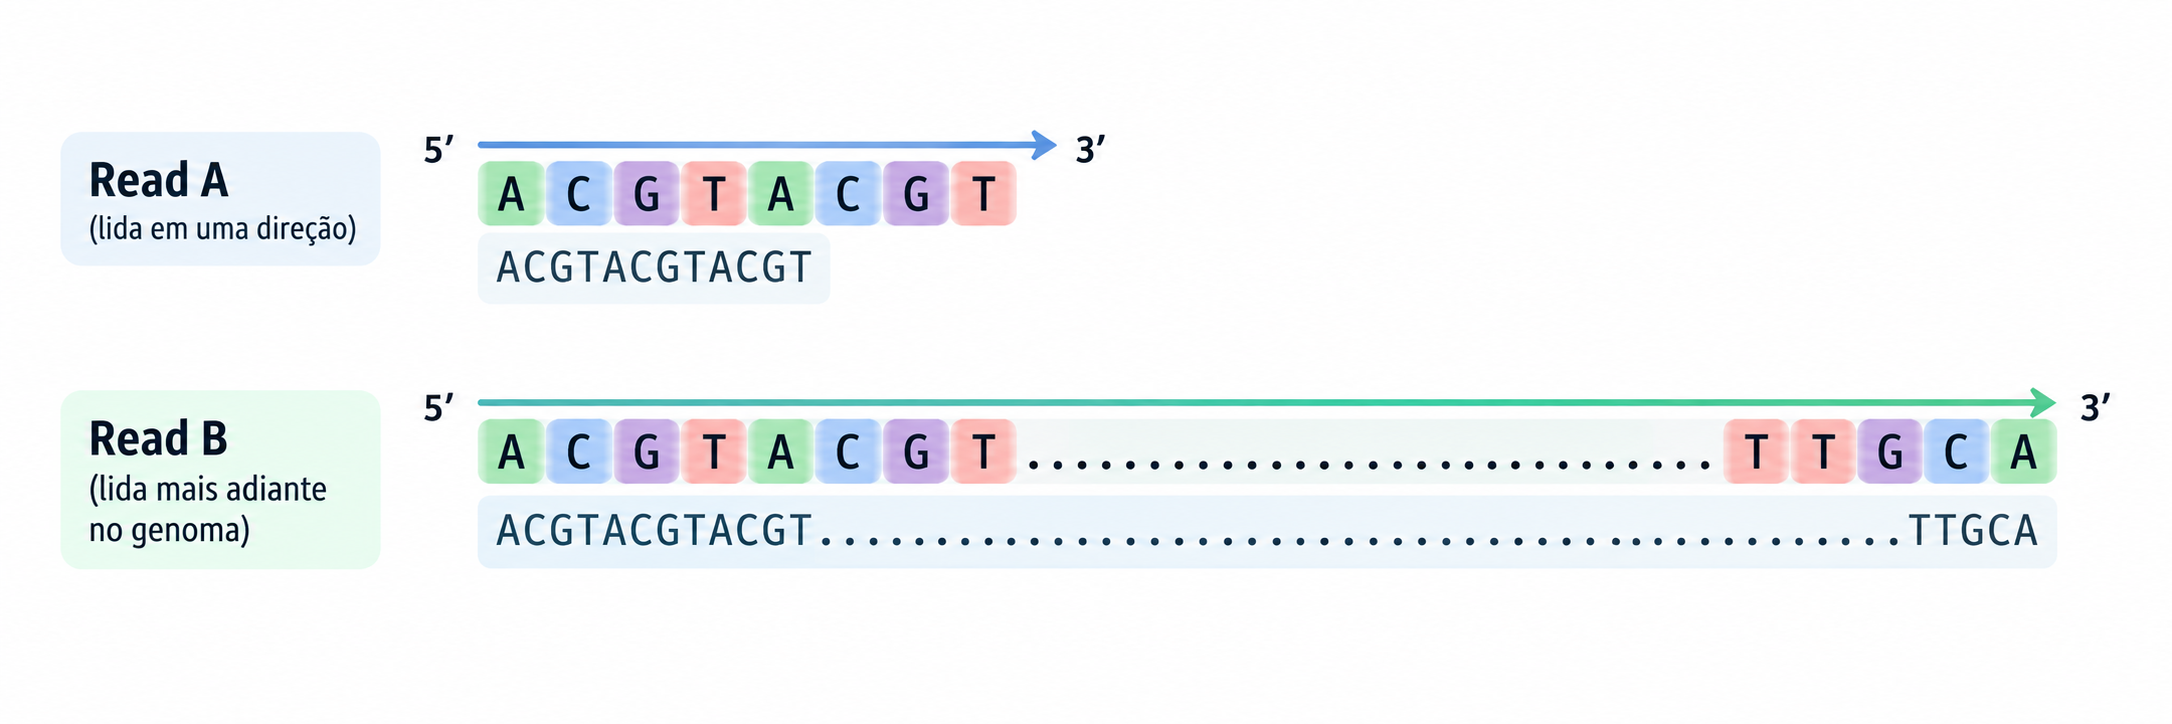
Mesmo que as duas sejam corretas, a segunda pode atravessar uma região genômica muito maior e conectar informações que a primeira não consegue relacionar.
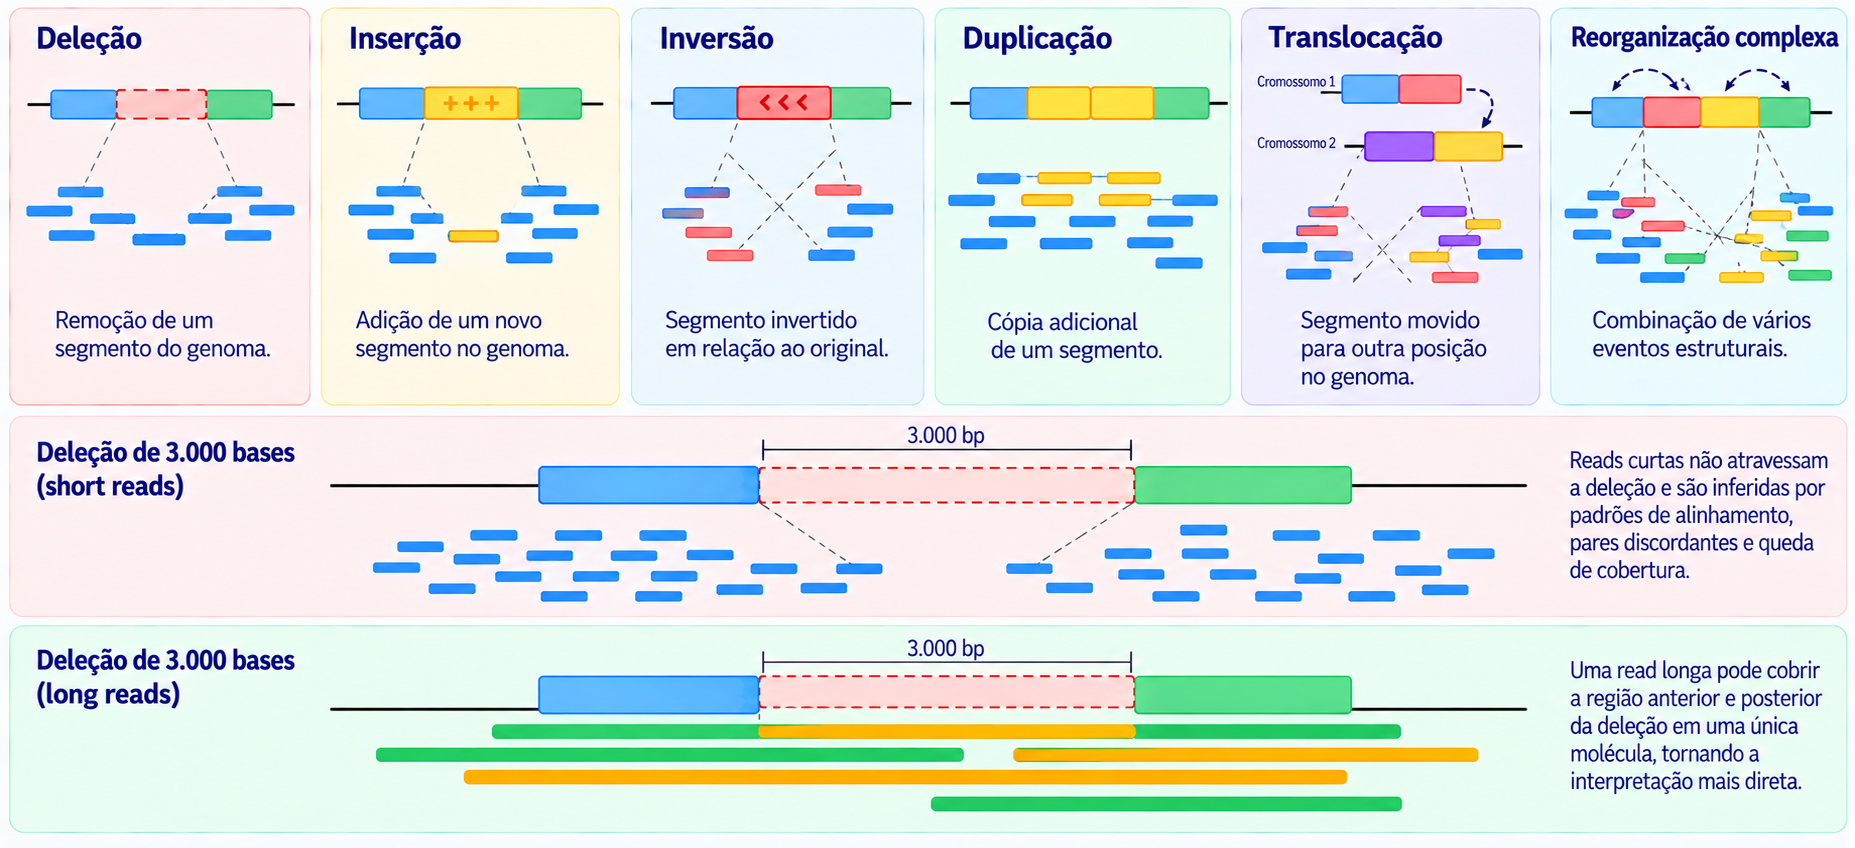
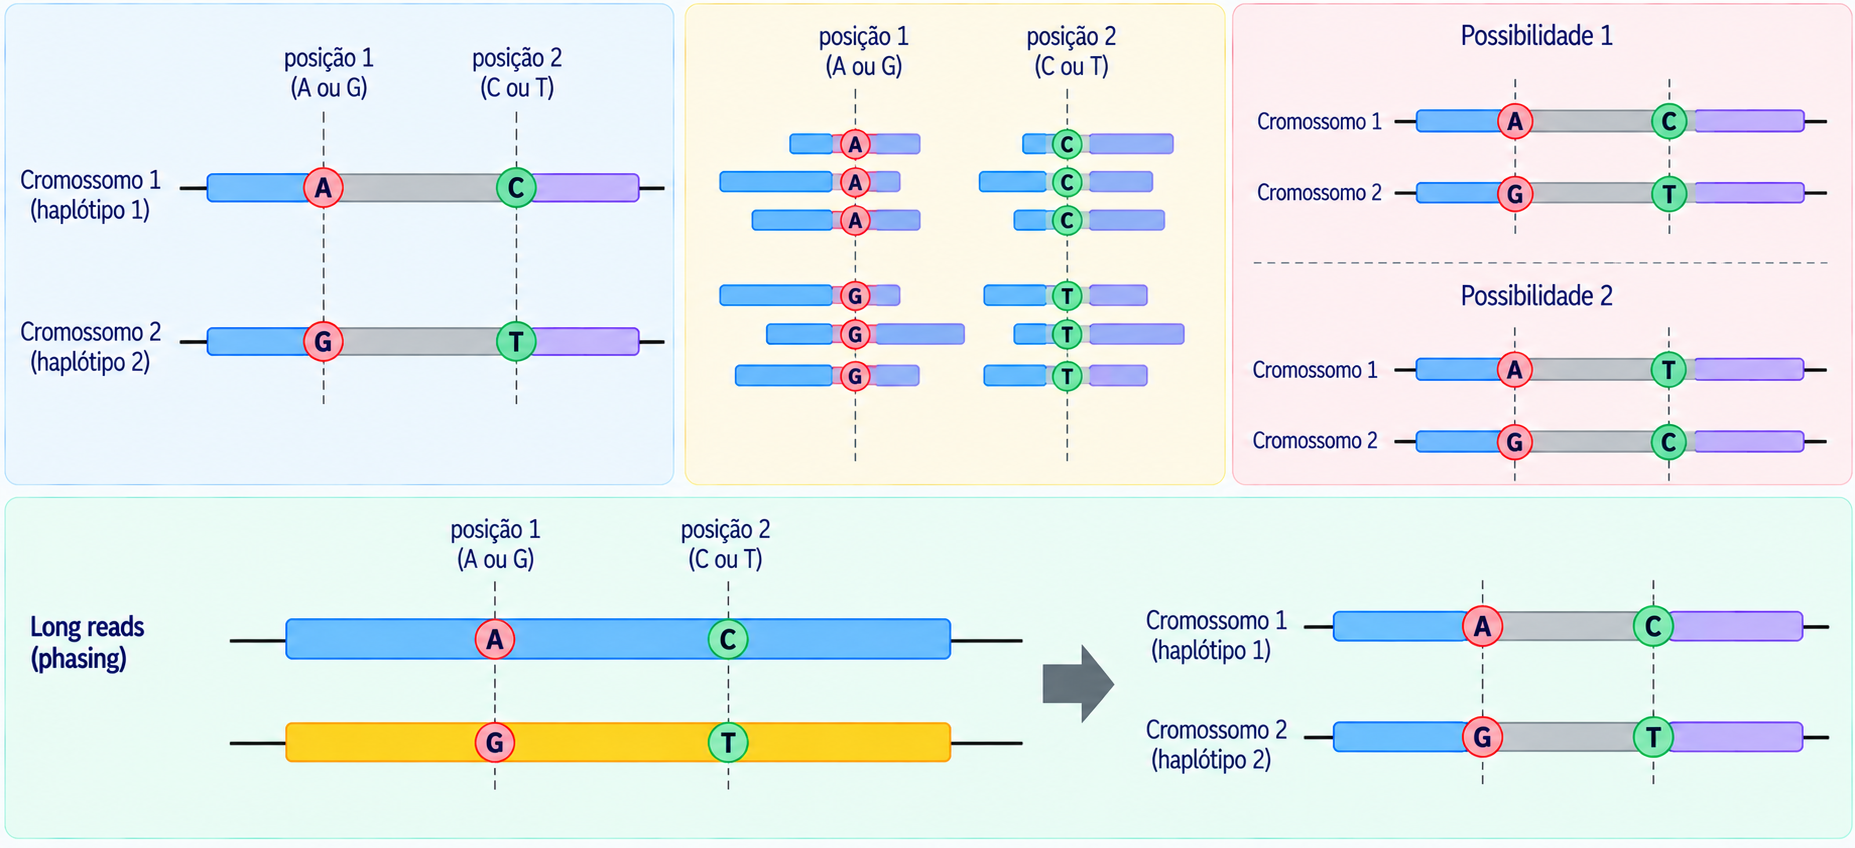
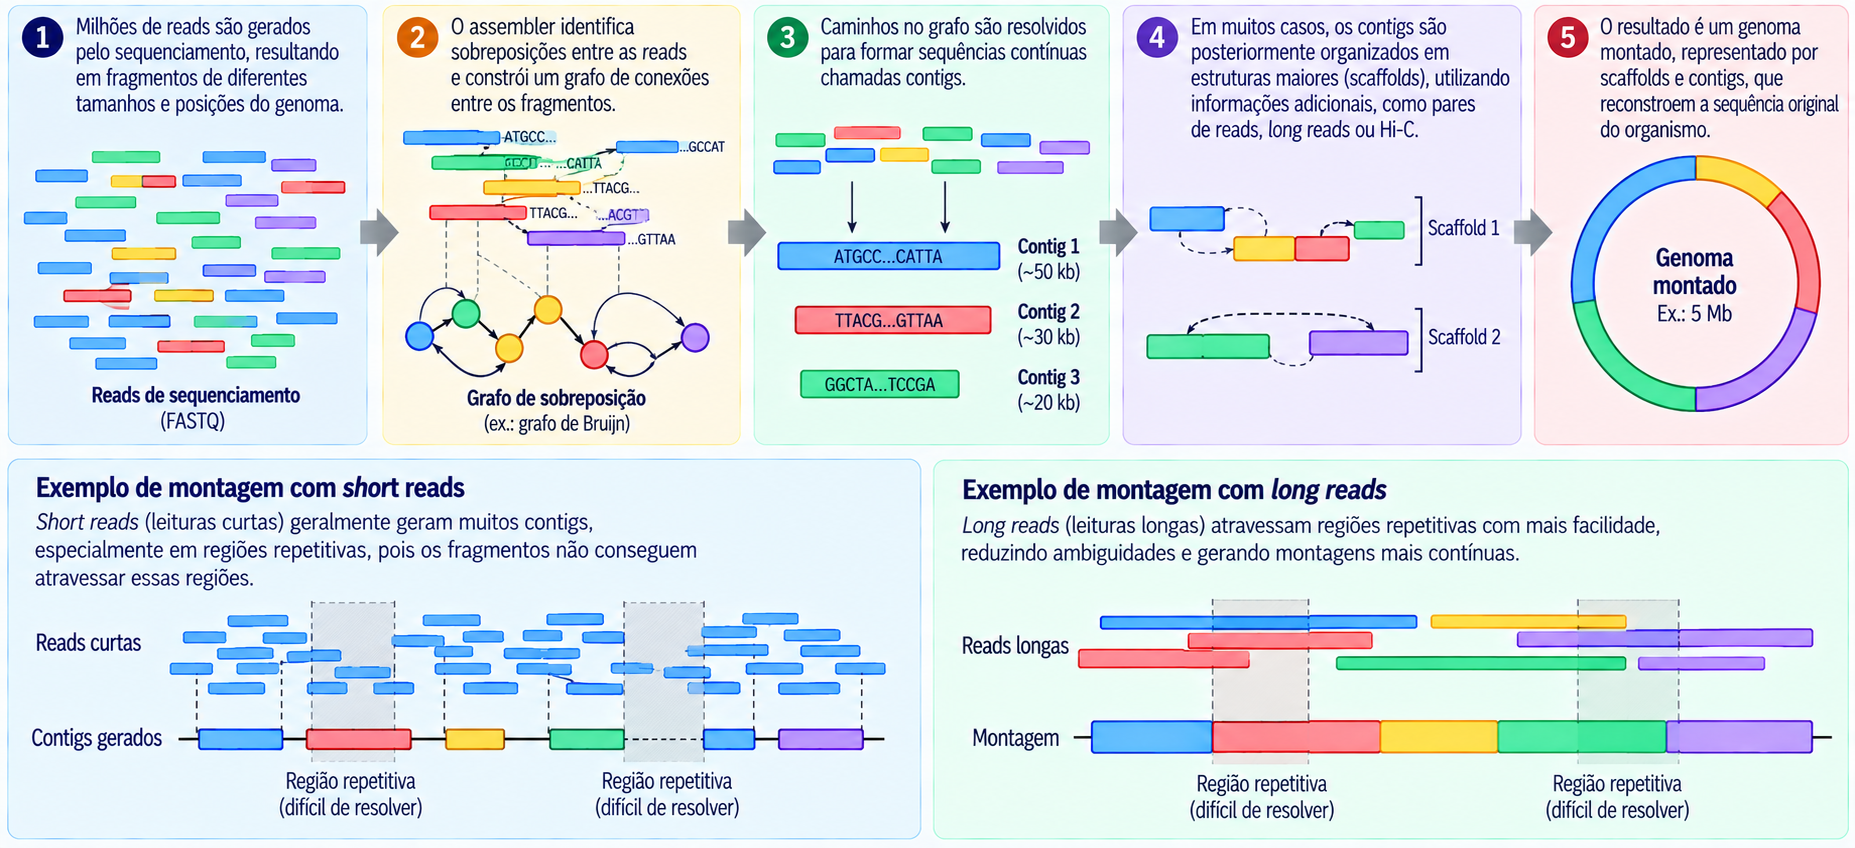
É exatamente essa diferença que torna o comprimento das reads tão importante em montagem de genomas, identificação de variantes estruturais e resolução de regiões repetitivas.
Checkpoint da unidade
É necessário acertar as 3 questões para liberar a unidade seguinte.